Что установлено
Мягкий пробел: почему `saiin` и `s aiin` - одно и то же, и что это говорит о шифре
Два соседних слова рукописи встречаются в той же книге ещё и слитно - в полтора раза чаще, чем случайно. Это свойство всех пяти транслитераций и обоих «языков». Мы воспроизвели его отдельным слоем модели, а потом обнаружили, что упёрлись в него же с другой стороны.
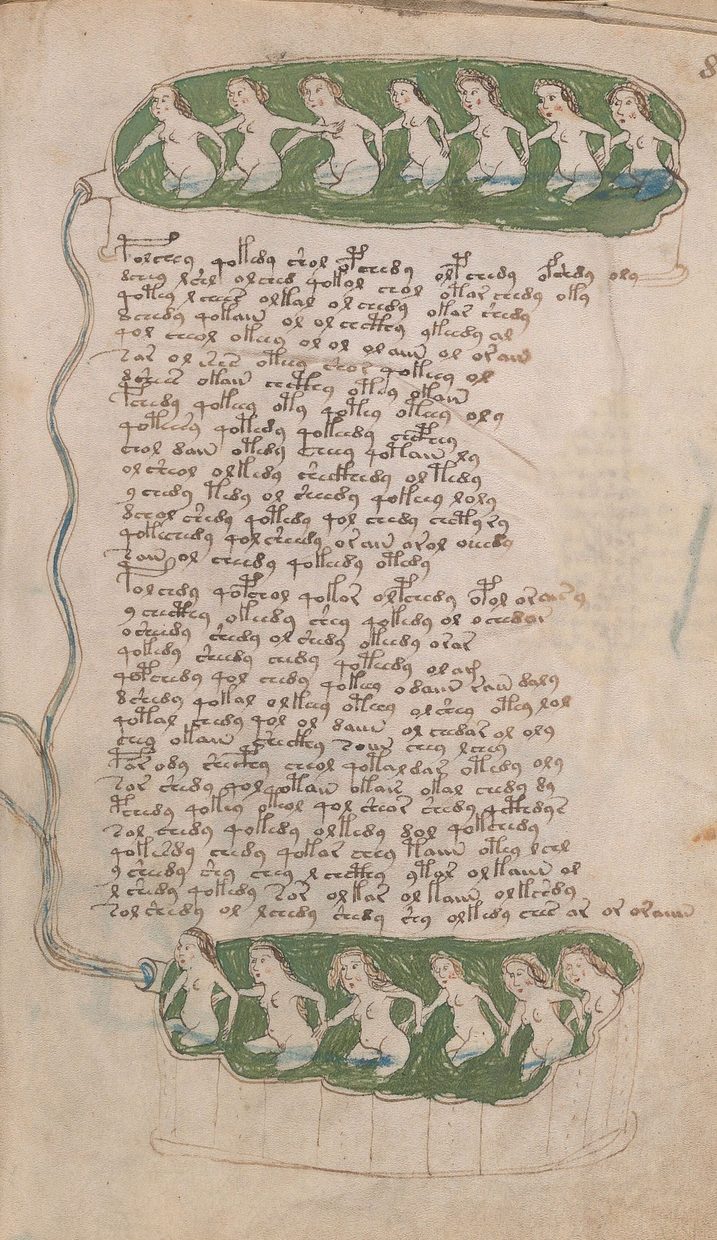
Слово aiin - одно из самых частых в рукописи, 483 вхождения. Перед ним часто стоит s: пара s aiin встречается 56 раз. А ещё 113 раз в книге написано saiin - слитно. or aiin - 51 раз раздельно и 29 слитно. ol chedy - 22 и 34. Писец, похоже, не очень твёрдо знал, где кончается одно слово и начинается другое.
Это наблюдение известно давно. Мы сделали из него измеримую величину, проверили её на всём, на чём можно, и получили один из самых чистых результатов проекта.
Мера
Берём каждую пару соседних разных слов в строке и спрашиваем: существует ли в корпусе их слитная форма одним словом? Доля таких пар - J. Нуль - слова перемешаны внутри строки. Избыток Δ = J минус нуль.
Рукопись: J 8.89 % при нуле 5.16 %, избыток +3.73 процентных пункта, z +31.6. Теперь проверки, без которых число ничего не стоит.
Пять независимых транслитераций - разные люди по-разному решали, где ставить пробел: ZL +3.73, Такахаси +2.37, v101 Кластона +4.67, FSG +1.78, Карриер +1.23. Все положительные, все значимые. Язык A +3.14, язык B +3.28. Пары через уверенный пробел (а не через сомнительный) +2.62. Середина строки +3.52. Слитная форма в 99 % случаев стоит на другой странице - это не писец скопировал соседнюю строку, это свойство системы.
Числа схемы
| Рукопись, ZL | +3.73 |
| Рукопись, Такахаси | +2.37 |
| Рукопись, v101 Кластона | +4.67 |
| Рукопись, FSG | +1.78 |
| Рукопись, Карриер | +1.23 |
| Канон до 07.10.2026 | +0.06 |
| 8 генераторов «слово - единица» | +0.00 |
| Канон со слоем «мягкий пробел» | +2.97 |
Кто несёт эффект
Несут пары с коротким словом. Если хоть одно слово в паре из одного-двух знаков - J 31 % при нуле 18 %. Если оба от трёх знаков - избыток всего +1.04 пункта. Левые части чередующихся пар - это ol, s, or, ar, o, l, r, y, qol: у o, l, s на чередующуюся пару приходится 65-72 % всех их вхождений. Правые - aiin, l, ar, al, chedy, r, shedy, ain: у aiin - 57 %.
Короткие группы, которые ходят и сами по себе, и приклеенными к соседу.
Нормально ли это
Мы проверили 105 текстов эпохи без OCR-ошибок - латынь, романские, германские - той же мерой. Рукопись стоит на 91-94-м перцентиле: высоко, но внутри диапазона. Того же порядка чередование у испанских медицинских текстов XV-XVI веков в транскрипции HSMS: de la и dela, en el и enel. У латинских изданий максимум +0.61 пункта. Так что величина сама по себе не аномалия письма эпохи.
Аномалия в другом. Мы прогнали меру через каталог генераторов. Наш канон того времени: +0.06 пункта, «нет» на десяти зёрнах из десяти. Восемь генераторов, где слово - неделимая единица (самокопирование, Тимм, решётки, вольвелла, шаблоны, двухступенчатые, память знаков), - ноль. Несёт только марковская цепь по словам, обученная на парах слов самой рукописи (63 %), - то есть копия. Потоковые генераторы, где пробел - состояние, дают 11-38 %. Цепь третьего порядка по глифам с пробелом как символом, обученная на рукописи, - 61-72 %: локальной статистики знаков хватает на две трети эффекта.
Слой «мягкий пробел»
Раз ни один генератор «слово - единица» эффекта не даёт, в модель нужен слой, где граница слова мягкая. Мы его построили и приняли по правилу: все охранные окна целы, ни одна из четырнадцати осей не хуже, целевая закрыта.
Устройство: слово, собранное из приставки и окончания, пишется в два токена по шву ячеек с вероятностью 0.35, если обе половины сами являются формами лексикона таблиц; с вероятностью 0.10, если только правая; иначе не рвётся. Склейка первого токена слова с предыдущим - 0.02. Разрыв и склейка тратят бюджет строки - число слов в строке не растёт. Решения принимает отдельный генератор случайных чисел, так что без слоя модель побайтно совпадает с прежней.
Результат на свежих зёрнах: +2.97 пункта при цели +3.73, несёт 10 зёрен из 10, состав пар как у рукописи. Попутно улучшились четыре другие оси. Дефект закрыт сменой канона 7 октября 2026 года.
Важная оговорка, которую мы записали тогда же: равномерный разрыв 10 % слов даёт 97 % величины, но не состав - у рукописи чередуются самостоятельные слова, у равномерного слоя распределение двугорбое. Поэтому слой сделан по словоподобности половин, а не по доле.
Та же точка с другой стороны
Через одиннадцать дней мы проверяли чужую ось - исследователь Доминик измерил связь класса слова с классом следующего слова. Канон величину несёт даже с перелётом. Но состав оказался другим: у рукописи только 46 % связи дают пары «тот же класс», у канона - 134 %. Недостающая половина - переходы между разными классами, и это ровно наши пары: s aiin 54 раза у рукописи и 0 у канона, or aiin 54 и 0.5, r aiin 22 и 0. Канон пишет saiin и raiin только слитно; одиночных s у него 4 против 270, одиночных r - 5.5 против 137.
Две независимые оси - чередование и класс соседа - упёрлись в одно место. В таблицах, на которых стоит модель, одна форма в разных ролях кодирует разные буквы: ol как слово - одна буква, как приставка - другая. Рукопись ведёт себя так, будто у неё общий инвентарь коротких групп на все позиции: s, r, o, l - и слово, и начало слова. Это гипотеза о правиле сборки, и проверять её надо генератором, а не подкруткой весов: мы прямо показали, что усиление или ослабление прайминга состав не изменит.
Для понимания: всё выше - о форме записи, не о значении. Удачей был бы генератор с общим инвентарём, который даст и чередование, и класс соседа, и таблицу «группа плюс aiin» в два раза от рукописи, не потеряв ни одной из прежних осей. Тогда правило сборки слова в модели изменится - и вместе с ним, возможно, устройство ключа, который ищет решатель.
Частые вопросы
Что значит слитно-раздельное чередование?
Берём два соседних слова строки, например s и aiin, и смотрим, есть ли в корпусе слово saiin. У рукописи такие пары составляют 8.89 процента против 5.16 при перемешке слов внутри строки. Избыток +3.73 процентных пункта, z +31.6.
Не артефакт ли это транскрипции - кто-то неверно поставил пробелы?
Нет. Эффект держится на пяти независимых делениях на слова - ZL, Такахаси, v101 Кластона, FSG, Карриер - в обоих «языках» и у трёх рук. Слитная форма в 99 процентах случаев стоит на другой странице - это не местное копирование.
Бывает ли такое в обычных текстах?
Бывает. Среди 105 текстов эпохи рукопись стоит на 91-94-м перцентиле - внутри диапазона. Того же порядка чередование у испанских медицинских текстов XV-XVI веков: de la и dela, en el и enel. Аномальна не величина, а то, что её не даёт ни один генератор, где слово - неделимая единица.
Как это связано с чтением?
Напрямую - нет. Но это один из немногих случаев, когда две независимые оси указали в одну точку устройства шифра: короткие группы вроде s, r, o, l ходят и отдельным словом, и началом слова. Если это так, правило сборки слова в модели нужно менять.