Che cosa è stabilito
Lo spazio morbido: perché `saiin` e `s aiin` sono la stessa cosa, e che cosa dice del cifrario
Due parole vicine del manoscritto compaiono nello stesso libro anche scritte unite, una volta e mezzo più spesso del caso. È una proprietà di tutte e cinque le traslitterazioni e di entrambe le «lingue». L'abbiamo riprodotta con uno strato separato del modello, e poi abbiamo scoperto di esserci imbattuti nella stessa cosa dall'altro lato.
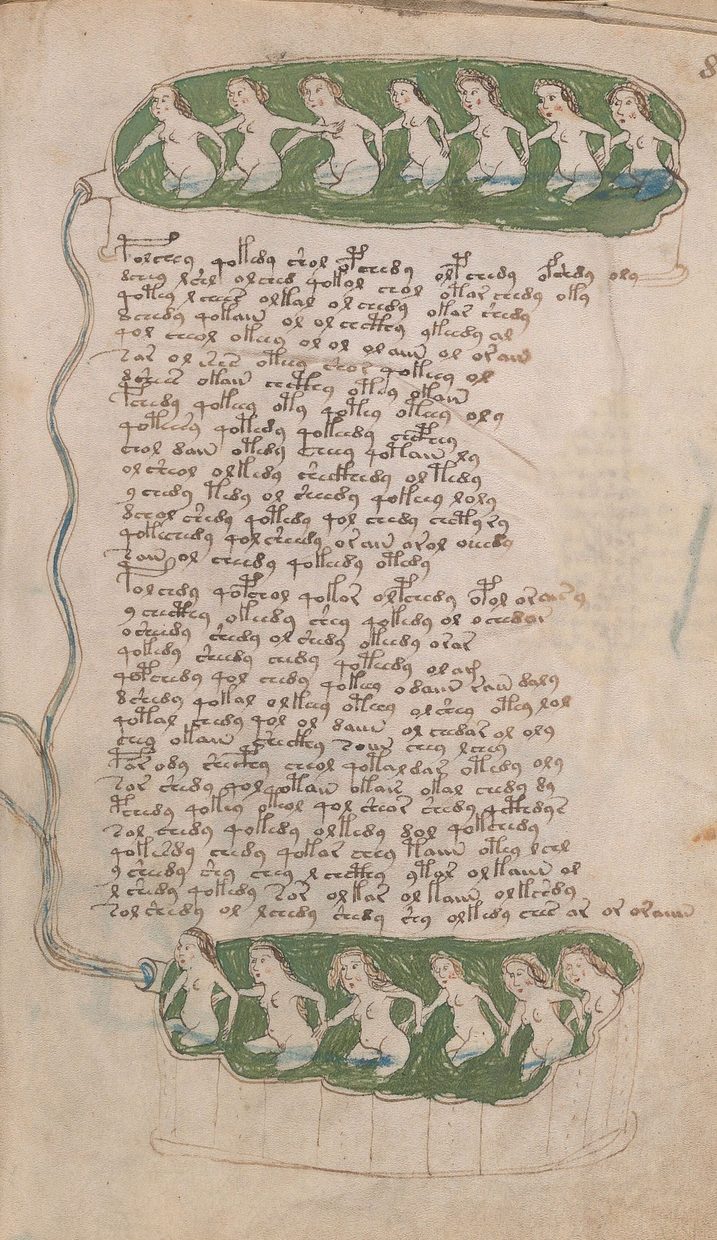
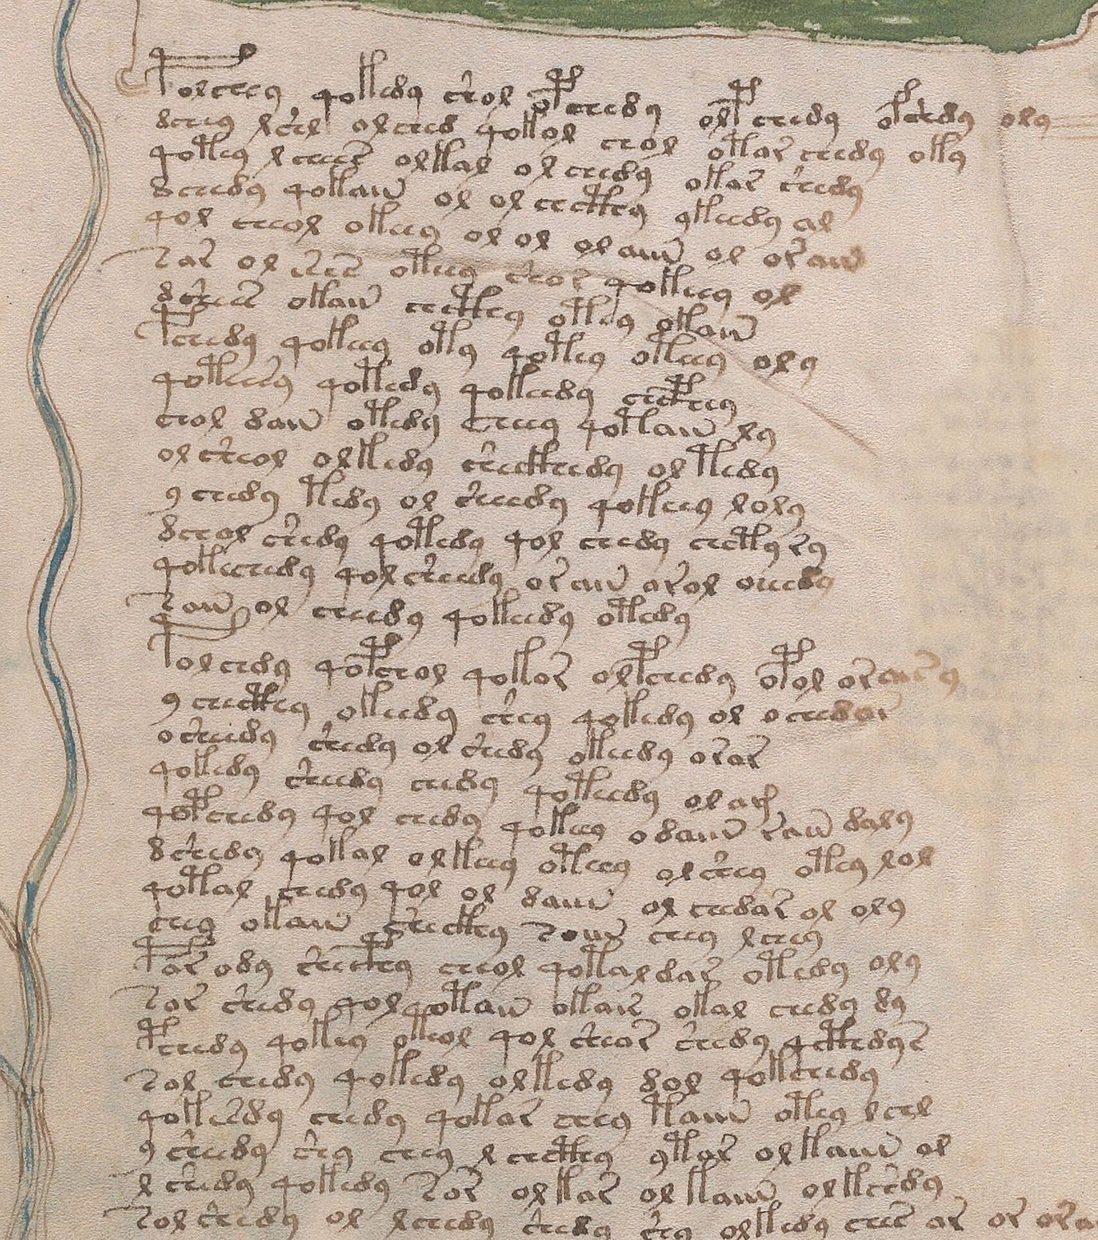
La parola aiin è una delle più frequenti del manoscritto: 483 occorrenze. Spesso è preceduta da s: la coppia s aiin ricorre 56 volte. E altre 113 volte nel libro è scritto saiin, tutto unito. or aiin: 51 volte staccato e 29 unito. ol chedy: 22 e 34. Lo scriba, a quanto pare, non sapeva con molta fermezza dove finisse una parola e dove cominciasse l'altra.
L'osservazione è nota da tempo. Noi ne abbiamo fatto una grandezza misurabile, l'abbiamo verificata su tutto ciò su cui si poteva, e abbiamo ottenuto uno dei risultati più puliti del progetto.
La misura
Prendiamo ogni coppia di parole vicine e diverse in una riga e chiediamo: nel corpus esiste la loro forma unita come parola sola? La quota di tali coppie è J. Il nullo: le parole rimescolate dentro la riga. L'eccesso Δ è J meno il nullo.
Il manoscritto: J 8.89 % con un nullo del 5.16 %, eccesso +3.73 punti percentuali, z +31.6. Ora le verifiche senza le quali il numero non vale nulla.
Cinque traslitterazioni indipendenti, cinque persone che hanno deciso ciascuna a modo suo dove mettere lo spazio: ZL +3.73, Takahashi +2.37, la v101 di Claston +4.67, FSG +1.78, Currier +1.23. Tutte positive, tutte significative. Lingua A +3.14, lingua B +3.28. Coppie separate da uno spazio sicuro (e non da uno dubbio) +2.62. Metà riga +3.52. Nel 99 % dei casi la forma unita sta su un'altra pagina: non è uno scriba che ha copiato la riga accanto, è una proprietà del sistema.
I numeri del grafico
| Manoscritto, ZL | +3.73 |
| Manoscritto, Takahashi | +2.37 |
| Manoscritto, v101 Claston | +4.67 |
| Manoscritto, FSG | +1.78 |
| Manoscritto, Currier | +1.23 |
| Canone prima del 07.10.2026 | +0.06 |
| 8 generatori «parola = unità» | +0.00 |
| Canone con lo strato «spazio morbido» | +2.97 |
Chi porta l'effetto
Lo portano le coppie con una parola breve. Se almeno una parola della coppia è di uno o due segni, J è il 31 % con un nullo del 18 %. Se entrambe sono di tre segni o più, l'eccesso è di appena +1.04 punti. I membri sinistri delle coppie alternanti sono ol, s, or, ar, o, l, r, y, qol: per o, l, s una coppia alternante copre il 65-72 % di tutte le loro occorrenze. I membri destri sono aiin, l, ar, al, chedy, r, shedy, ain: per aiin, il 57 %.
Gruppi brevi che vanno sia da soli sia incollati al vicino.
È normale?
Abbiamo fatto passare per la stessa misura 105 testi dell'epoca senza errori di OCR: latino, romanzi, germanici. Il manoscritto sta al 91°-94° percentile: in alto, ma dentro l'intervallo. Un'alternanza dello stesso ordine si trova nei testi medici spagnoli del Quattrocento e del Cinquecento nella trascrizione HSMS: de la e dela, en el e enel. Le edizioni latine danno al massimo +0.61 punti. Dunque la grandezza in sé non è un'anomalia della scrittura dell'epoca.
L'anomalia sta altrove. Abbiamo fatto passare la misura per il catalogo dei generatori. Il nostro canone di allora: +0.06 punti, un «no» su dieci semi su dieci. Otto generatori in cui la parola è un'unità indivisibile (autocopiatura, Timm, griglie, volvella, schemi, a due stadi, memoria dei segni): zero. La porta soltanto una catena di Markov per parole addestrata sulle coppie di parole del manoscritto stesso (63 %), cioè una copia. I generatori a flusso, in cui lo spazio è uno stato, danno l'11-38 %. Una catena del terzo ordine sui glifi con lo spazio come simbolo, addestrata sul manoscritto, dà il 61-72 %: la statistica locale dei segni basta per due terzi dell'effetto.
Lo strato «spazio morbido»
Se nessun generatore «parola = unità» dà l'effetto, al modello serve uno strato in cui il confine di parola è morbido. L'abbiamo costruito e accettato secondo la regola: tutte le finestre di guardia intatte, nessuno dei quattordici assi peggiorato, quello bersaglio chiuso.
Il congegno: una parola assemblata da prefisso e desinenza si scrive in due token, spezzata sulla giuntura delle celle, con probabilità 0.35 se entrambe le metà sono a loro volta forme del lessico delle tavole; con probabilità 0.10 se lo è solo la destra; altrimenti non si spezza. L'incollatura del primo token di una parola al precedente: 0.02. Rottura e incollatura spendono il budget della riga: il numero di parole nella riga non cresce. Le decisioni le prende un generatore di numeri casuali separato, così che senza lo strato il modello coincide byte per byte con quello di prima.
Il risultato su semi freschi: +2.97 punti contro un bersaglio di +3.73, lo portano 10 semi su 10, la composizione delle coppie è quella del manoscritto. Lungo la strada sono migliorati altri quattro assi. Il difetto è stato chiuso con il cambio di canone del 7 ottobre 2026.
Una riserva importante, che abbiamo messo per iscritto allora stesso: una rottura uniforme del 10 % delle parole dà il 97 % della grandezza ma non la composizione: nel manoscritto ad alternarsi sono parole autonome, mentre lo strato uniforme dà una distribuzione a due gobbe. Per questo lo strato è costruito sulla somiglianza a parola delle due metà, non su una quota.
Lo stesso punto dall'altro lato
Undici giorni dopo stavamo verificando un asse altrui: il ricercatore Dominik ha misurato il legame fra la classe di una parola e la classe della parola successiva. Il canone la grandezza la porta, perfino con un sorpasso. Ma la composizione è risultata diversa: nel manoscritto solo il 46 % del legame viene dalle coppie «stessa classe», nel canone il 134 %. La metà mancante sono i passaggi fra classi diverse, e sono esattamente le nostre coppie: s aiin 54 volte nel manoscritto e 0 nel canone, or aiin 54 e 0.5, r aiin 22 e 0. Il canone scrive saiin e raiin solo uniti; di s isolate ne ha 4 contro 270, di r isolate 5.5 contro 137.
Due assi indipendenti, l'alternanza e la classe del vicino, sono andati a sbattere nello stesso posto. Nelle tavole su cui poggia il modello, una stessa forma in ruoli diversi codifica lettere diverse: ol come parola è una lettera, come prefisso un'altra. Il manoscritto si comporta come se avesse un inventario comune di gruppi brevi per tutte le posizioni: s, r, o, l sono parola e insieme inizio di parola. È un'ipotesi sulla regola di assemblaggio, e va verificata con un generatore, non ritoccando i pesi: abbiamo mostrato direttamente che rafforzare o indebolire il priming non cambia la composizione.
Per intendersi: tutto quanto sopra riguarda la forma della scrittura, non il significato. Un successo sarebbe un generatore con inventario comune che dia l'alternanza, la classe del vicino e la tabella «gruppo più aiin» entro un fattore due dal manoscritto, senza perdere nessuno degli assi precedenti. Allora la regola di assemblaggio della parola nel modello cambierebbe, e con essa, forse, la struttura della chiave che il risolutore sta cercando.
Domande frequenti
Che cosa significa alternanza fra scrittura unita e staccata?
Prendiamo due parole vicine di una riga, per esempio s e aiin, e guardiamo se nel corpus esiste la parola saiin. Nel manoscritto queste coppie sono l'8.89 per cento contro il 5.16 quando le parole vengono rimescolate dentro la riga. L'eccesso è di +3.73 punti percentuali, z +31.6.
Non sarà un artefatto della trascrizione, qualcuno che ha messo male gli spazi?
No. L'effetto regge su cinque divisioni in parole indipendenti - ZL, Takahashi, la v101 di Claston, FSG, Currier - in entrambe le «lingue» e in tre mani. Nel 99 per cento dei casi la forma unita sta su un'altra pagina: non è una copiatura locale.
Succede anche nei testi ordinari?
Succede. Fra 105 testi dell'epoca il manoscritto sta al 91°-94° percentile, dentro l'intervallo. Un'alternanza dello stesso ordine si trova nei testi medici spagnoli del Quattrocento e del Cinquecento: de la e dela, en el e enel. L'anomalia non è la grandezza, ma il fatto che non la dia nessun generatore in cui la parola è un'unità indivisibile.
Che legame ha con la lettura?
Diretto, nessuno. Ma è uno dei pochi casi in cui due assi indipendenti hanno indicato lo stesso punto della struttura del cifrario: gruppi brevi come s, r, o, l vanno sia come parola a sé sia come inizio di parola. Se è così, la regola di assemblaggio della parola nel modello va cambiata.