Близкие промахи
Армянский след: как мы закрыли язык четырьмя способами - и что нашли по дороге
Версия об армянском языке рукописи держится на двух вещах: похожих буквах и травах с Востока. Мы проверили структуру текста, форму знаков по шрифтам и по настоящим рукописям, провели слепой квиз - и получили четыре нуля. А потом удвоенные слоги рукописи вывели на лечебник XV века и три независимые традиции. Это оказался промах другого рода.
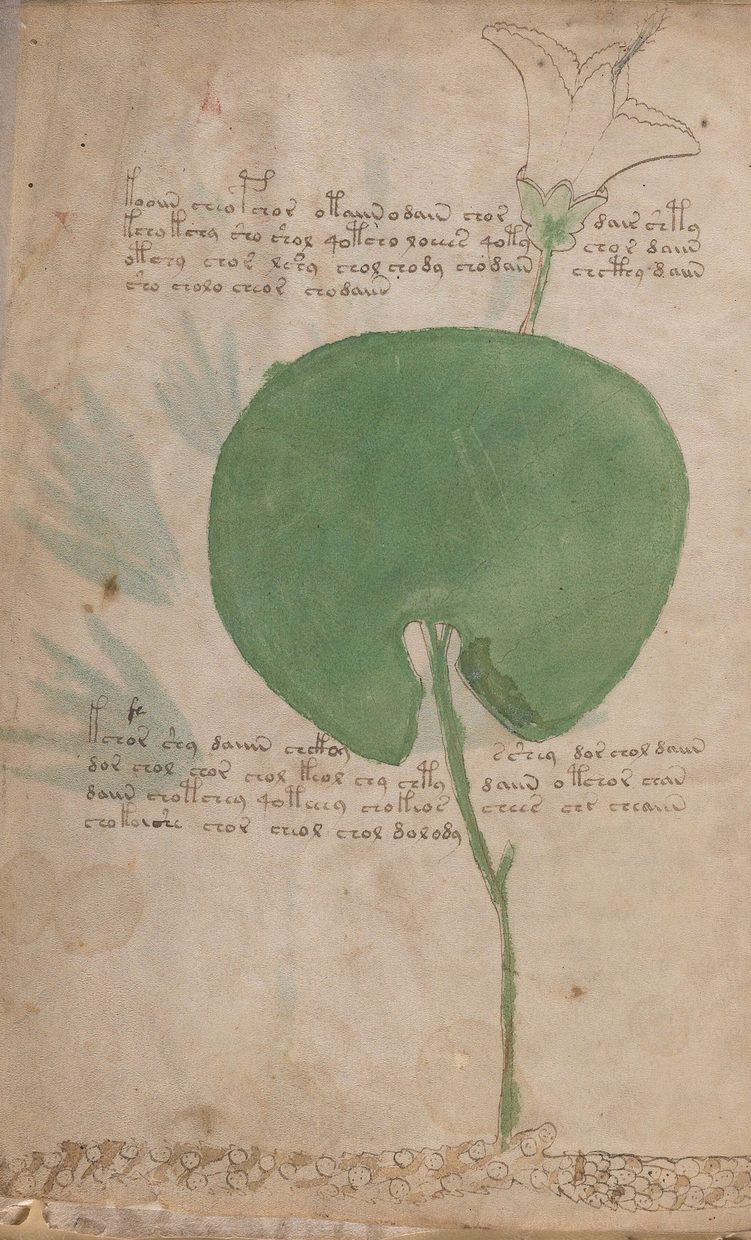
Армянская версия манускрипта Войнича - из тех, что живут десятилетиями на двух доводах: некоторые знаки похожи на армянские буквы, а среди растений травника есть восточные. Доводы слабые, но правило проекта - версию сначала развивать, потом судить. В августе 2026 года мы развили её по четырём независимым каналам. Все четыре дали ноль. А по дороге нашлось кое-что, чего мы не искали.
Канал первый: структура текста
Если рукопись - армянский текст под нашим шифром, его статистический отпечаток должен быть ближе к рукописи, чем отпечаток латыни. Мы взяли два корпуса: грабар V века (393 тысячи букв) и лечебник Амирдовлата Амасиаци XV века (959 тысяч) - последний важен вдвойне, потому что лечебник - эталон жанра, который мы считаем жанром рукописи.
Батарея из шести осей при равном объёме: армянский проходит одну, латынь - три. Кучность двойников 1.44-1.51, двойники 2.5-2.9 %. Контроль проекции алфавита (38 букв против 22) разрыв не объясняет, хотя зазор невелик. Слово kchor, которое сторонники читали как название растения, встречается 19 раз на 19 разных растениях - подпись одного растения так не ведёт себя. Отвергать язык по одному отпечатку мы не стали бы - это первый ноль из четырёх, не вердикт.
Канал второй: форма букв по шрифтам
Насколько знаки рукописи похожи на армянские буквы? Мы сравнили их по шрифтам - армянскому, латинскому, греческому, кириллическому, грузинскому - с критерием, заданным до прогона. Армянский действительно ближе латиницы, греческого и кириллицы (p 0.000). Но ровно настолько же близок грузинский мхедрули: 0.749 против 0.754, p 0.901. Это свойство класса округлых курсивов, не армянского. Девять из десяти лучших пар совпадают только через поворот или зеркало.
Канал третий: форма букв по настоящим рукописям
Шрифты - идеализация. Мы нарезали 300 фрагментов из настоящих рукописей эпохи: армянский болоргир из двух кодексов 1455 и 1475 годов - ровно окно радиоуглерода, - и контроли XV века: латинская бастарда, греческий минускул, грузинский мхедрули. Из рукописи - два листа, по одному на каждый «язык». Нарезка механическая, критерий до данных, контраст нормализован, чтобы стиль фотосъёмки не выдавал источник.
Сигнал инвертировался. Армянский оказался хуже всех: 0.788 против 0.792 у латыни, 0.796 у грузинского и 0.810 у греческого. Сходство по шрифтам было свойством шрифтов, а не букв.
Канал четвёртый: слепой квиз
Последняя проверка - человеческий глаз без знания гипотезы. Тридцать заданий, в каждом восемь вариантов по два на письменность, обезличенные фрагменты, возможность выбрать до трёх или ответить «ни один». Скоринг заморожен до ответов. Выбор по нулю - 25 % на письменность. Получилось: армянский 28.1 %, латынь 28.9 %, греческий 21.9 %, грузинский 21.1 %, p 0.342. «Ни один» - в 11 заданиях из 30. Лёгкий лидер - латынь, в унисон с другим тестом, где форма знаков рукописи совпала с латинской палеографией сокращений.
Четыре канала, четыре нуля. Армянский язык закрыт.
Числа схемы
| Канал 2: сходство знаков со шрифтами - армянский | 0.749 |
| Канал 2: сходство знаков со шрифтами - грузинский | 0.754 |
| Канал 3: сходство с настоящими рукописями XV века - армянский | 0.788 |
| Канал 3: сходство с настоящими рукописями XV века - латынь | 0.792 |
| Канал 3: сходство с настоящими рукописями XV века - грузинский | 0.796 |
| Канал 3: сходство с настоящими рукописями XV века - греческий | 0.810 |
| Канал 4: слепой квиз, выбор человека, % - грузинский | 21.1 |
| Канал 4: слепой квиз, выбор человека, % - греческий | 21.9 |
| Канал 4: слепой квиз, выбор человека, % - армянский | 28.1 |
| Канал 4: слепой квиз, выбор человека, % - латынь | 28.9 |
Что нашлось по дороге
Пока работал первый канал, мы разбирали подписи у двух лоз на листе f78r и прогнали одну из них - oteoteotsho - по 57 корпусам. Целиком она не нашлась нигде. Но её ядро, ote-ote, повторённый слог, возглавляет список именно у Амирдовлата: 1.34 на тысячу слов, тогда как среди корпусов от пяти тысяч слов больше 0.42 не даёт никто. И это удвоенные имена снадобий арабского корня.
Дальше - проверка, что это не армянская особенность. Латинский Antidotarium даёт тот же уровень для слогов из трёх букв: 0.53 %. После добора те же слова нашлись у османов - hashas, mermer, bulbul, zemzem - и у коптов. Три независимые традиции. А у общелитературного османского текста плотность 0.24 против 1.34 у лечебника. Черта жанра, не языка: лечебники любят удвоенные названия.
Число для рукописи: 2.04 % типов с удвоенным двузнаком и 0.18 % с удвоенным трёхзнаком - полоса лечебников, втрое выше прозы. Все 14 типов с тройным удвоением - одно гнездо: daldal, kalkal, oteotey. Мы записали это как лид: удвоенные слоги - отпечаток жанра.
Промах другого рода
Лид прожил месяц. В сентябре мы измерили ту же величину иначе - как долю типов с удвоенным двузнаком, olol, arar, - и прогнали через генератор. Рукопись 1.77 %, канон 0.25-0.37 %, пять зёрен из пяти ниже половины цели. Это дефект модели, и он родственник другого дефекта - соседнего повтора слова: у рукописи два соседних слова чаще совпадают, чем у модели, и часть таких повторов пишется слитно. Удвоенный слог - слитный соседний повтор. Не жанр открытого текста, а свойство записи.
Так лид закрылся - не потому, что совпадение с лечебниками было ложным, а потому, что у рукописи есть более близкое объяснение, не требующее языка вообще. Это промах особого рода: правильное наблюдение, правильный жанр, неправильный уровень объяснения.
Для понимания: четыре нуля закрывают армянский как язык открытого текста под нашим классом шифра; восточные растения травника этим не объясняются и не опровергаются. Удачей была бы не похожая буква, а армянский текст, который под шифром давал бы профиль рукописи, - такого не нашлось.
Частые вопросы
Почему армянский вообще рассматривался?
Из-за внешнего сходства некоторых знаков рукописи с армянскими буквами и из-за восточных растений в травнике. Это слабые доводы, но правило проекта - сначала развивать версию, потом судить.
Как проверяли сходство букв?
Тремя способами. По шрифтам - армянский действительно ближе латиницы и греческого, но ровно настолько же близок грузинский мхедрули: это свойство округлых курсивов вообще. По настоящим рукописям эпохи - сигнал инвертировался, армянские образцы оказались хуже всех. Слепым квизом - выбор армянского на уровне случайности.
Что такое удвоенные слоги и почему они важны?
Слова вроде ote-ote-y или dal-dal, где слог повторён дважды. В рукописи их заметно больше, чем в прозе. Мы нашли такую же плотность в лечебнике Амирдовлата XV века и в названиях снадобий у османов и коптов - это черта жанра лечебников, не языка.
Чем всё закончилось?
Язык закрыт четырьмя нулями. А удвоенные слоги позже оказались не отпечатком жанра, а следствием механизма: у рукописи это слитный повтор соседних слов, и наш генератор его недодаёт - это дефект модели, родственник другого известного дефекта.