Что установлено
Шесть таблиц и пять писцов: как устроен текст манускрипта Войнича
Мы не прочитали ни слова, но знаем, как этот текст был сделан. История о том, как из одной аномалии - слишком предсказуемого текста - выросла модель, которая воспроизводит десять статистик рукописи разом, и о двадцати местах, где она всё ещё ошибается.
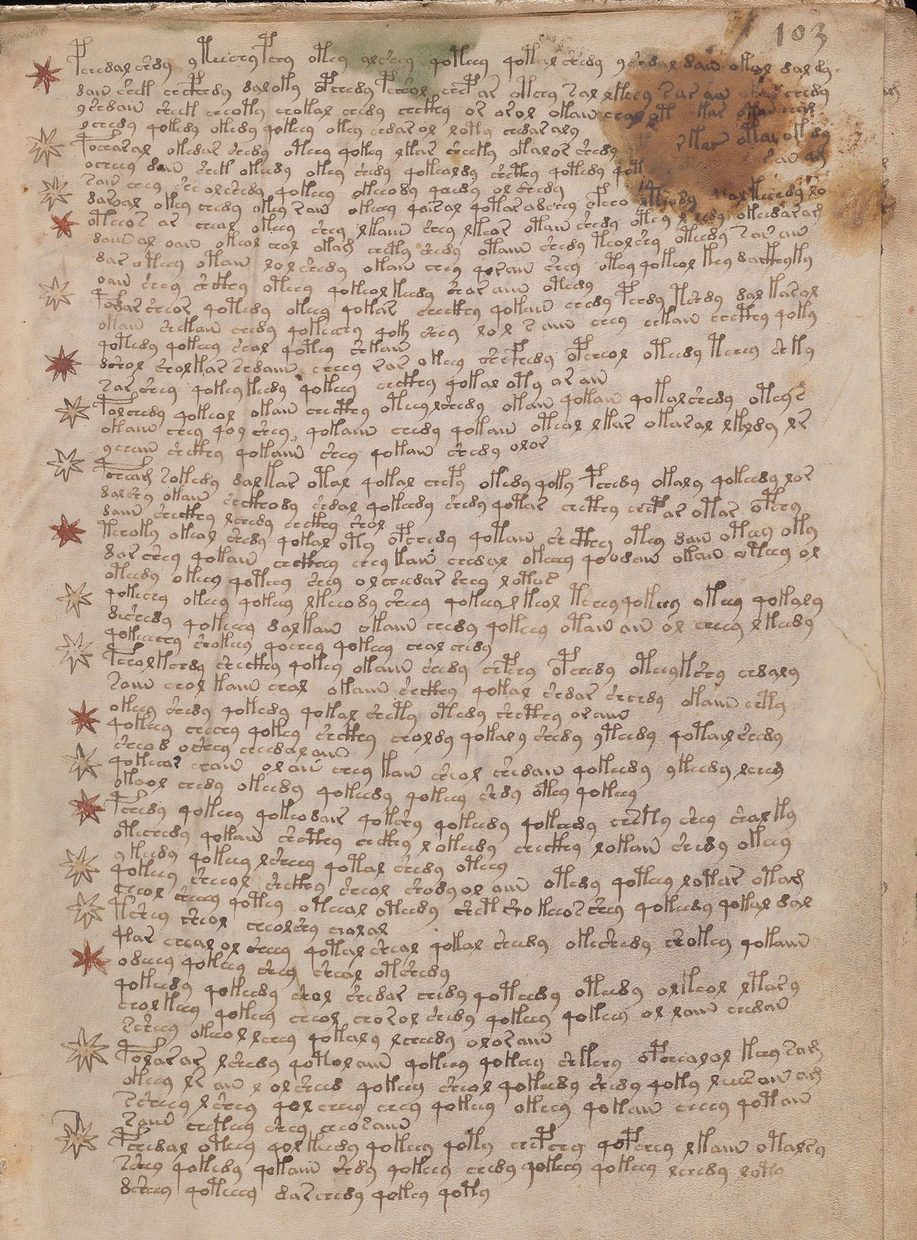
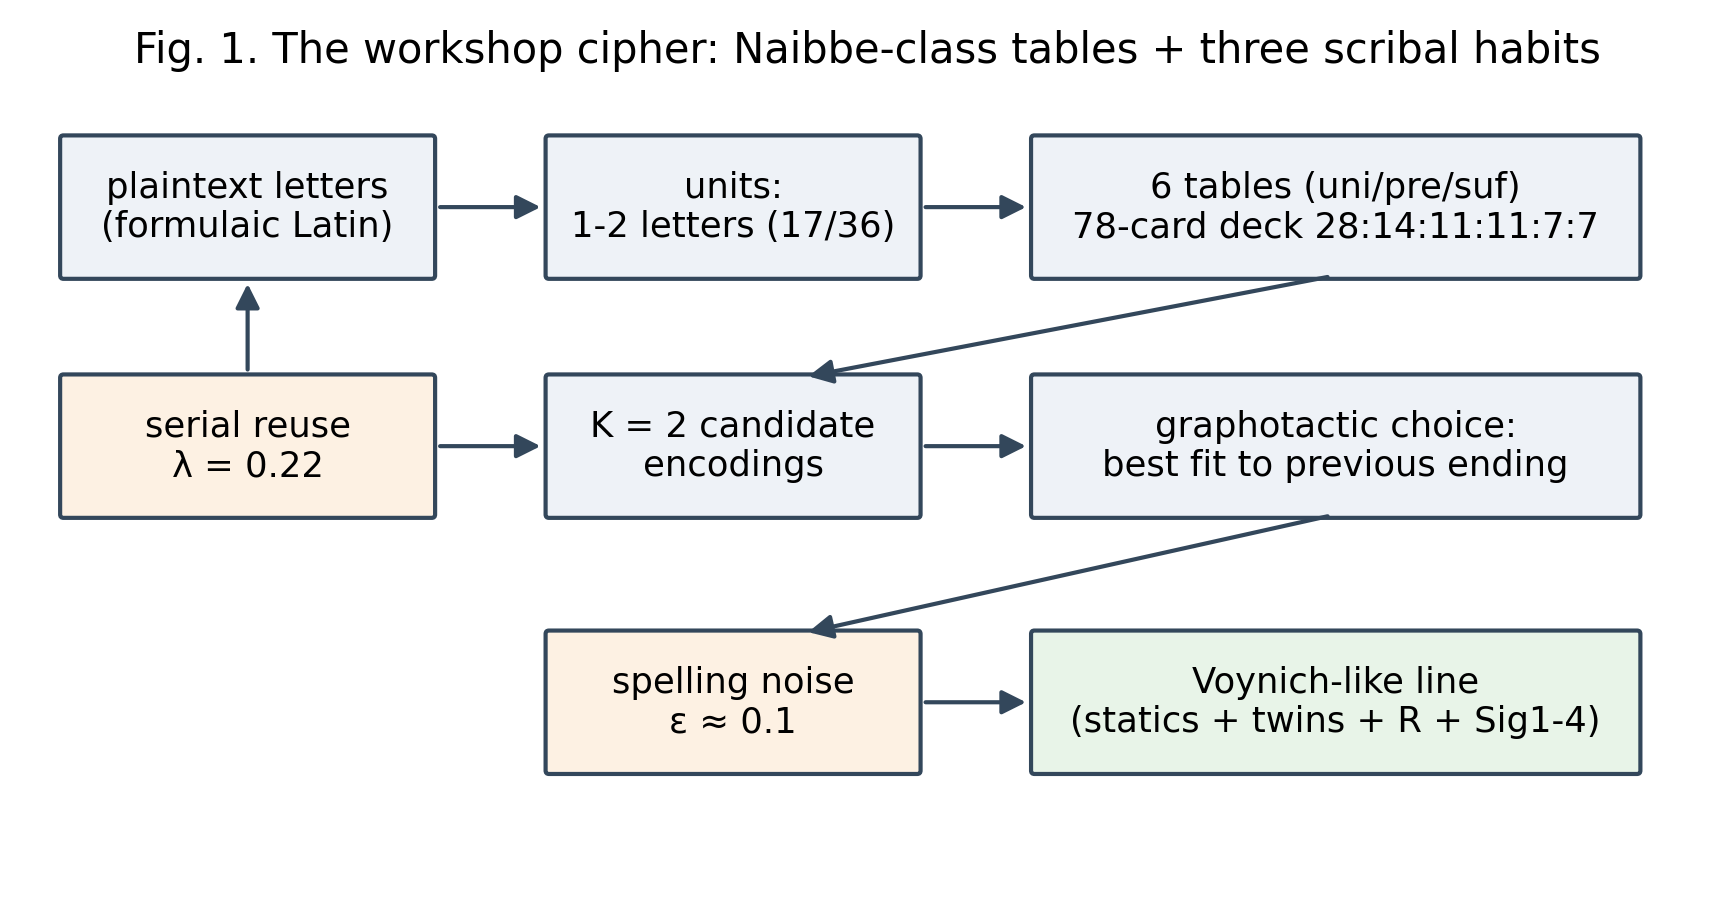
Представьте писца, перед которым лежат шесть таблиц. В каждой - латинский алфавит, и против каждой буквы стоит группа чужих знаков: одна для буквы в начале слова, другая для середины, третья для конца. Писец берёт слог исходного текста, бросает взгляд на одну из трёх таблиц, которыми работает сегодня, и выводит на пергамент «слово». Потом следующий слог, следующее «слово». Он немного ленится: если подходящая группа стоит перед глазами - в предыдущем слове строки, - он охотнее возьмёт её снова. Если прошлое слово кончилось на определённый знак, он подберёт вариант, который красиво к нему пристыкуется. Иногда он разрывает одно «слово» на два там, где обе половины сами похожи на слова.
Это не реконструкция по документу - документа нет. Это модель, которую мы собирали слой за слоем почти год, и каждый слой принимался только по заранее объявленному критерию. Ниже - как она собиралась и что умеет.
Аномалия, с которой всё началось
Текст манускрипта Войнича ведёт себя как язык - в нём есть закон Ципфа, чередование «гласных» и «согласных», тематическая лексика по разделам. И одновременно не как язык: условная энтропия, то есть предсказуемость следующего знака по предыдущему, у него 2.08-2.30 бита. У латыни, английского, финского, немецкого и ещё двух десятков языков - от 2.96 до 3.23. Такого низкого значения при таком богатом словаре нет ни у одного естественного языка в его обычной орфографии. Мы называем это пустым углом, и в нём сидит только рукопись.
Простой шифр замены энтропию не меняет: мы прогнали латынь через замену «буква в знак» - 3.22 как было, так и осталось. А вот замена «буква в два знака» роняет её до 2.11. Это и есть первый довод за вербозный шифр: он единственный из простых механизмов воспроизводит главную странность текста.
Класс найден независимо дважды
В июле 2026 года мы прогнали через свои метрики текст, зашифрованный системой Naibbe - исторически правдоподобным шифром, который Майкл Грешко построил из карт и костей и опубликовал в Cryptologia. Шесть таблиц, слоговая замена, гомофоны. Его шифртекст Плиния дал низкую энтропию 2.08, правильную длину слова, правильную долю аффиксов и - главное - наш острейший признак: 80 % слов обслуживают около шестидесяти «ядер». У рукописи таких ядер 55, у латыни-источника 641.
Два независимых подхода сошлись на одном классе механизмов. Дальше была наша работа: класс - это ещё не модель.
Слои модели и что каждый закрывает
Каждый слой добавлялся по одной причине: предыдущая версия не воспроизводила какую-то измеренную статистику рукописи. И каждый принимался по правилу: все прежние показатели целы, целевой улучшился, ни один не ухудшился.
Шесть таблиц. Статика: длина слова, энтропия, доля словаря. Меньше шести - мало двойников, перекос - портит всё.
Двойники и переиспользование. В рукописи 42 пары слов с формально разной записью и одинаковыми контекстами - ol и chey, daiin и chol. Граф таких пар распадается ровно на две компоненты по «языкам» A и B. Двойники кучкуются в строке в 1.87 раза сильнее случайного. Это серийность: писец переиспользует единицы строки с вероятностью около 0.22.
Секционный диалект. Слова рукописи кучны: одни формы густо идут на отрезке текста, потом сменяются. Это воспроизводится, если писец работает тремя таблицами из шести на отрезке примерно в 220 строк - медиане тетради. Побочный эффект - показатель Тейлора 0.650 при цели 0.678 и закрытие спора о «двух языках»: A и B - два лексикона одной системы.
Сандхи - стык слов. Между концом слова и началом следующего в рукописи 0.165 бита информации. Гомофония этого не даёт, переиспользование тоже. Даёт выбор из трёх вариантов написания по стыку с предыдущим словом. Предпочтения стыковки переносятся из языка A в язык B (корреляция 0.75) - писцовый обычай, а не свойство открытого текста.
Прайминг соседом. Писец охотнее берёт вариант с тем же первым знаком, что у предыдущего слова (вес 1.75), и близкой длины (1.35). Этот слой закрыл четыре оси разом.
Мягкий пробел. Слово из двух ячеек пишется раздельно с вероятностью 0.35, если обе половины похожи на слова. Так закрылось слитно-раздельное чередование.
Технология, а не почерк
Самый сильный довод за «цех», а не за одного шифровальщика, дал тест по пяти рукам. Палеограф Лиза Фейгин Дэвис различает в рукописи пять писцов. Если бы каждый кодировал по-своему, варианты написания у разных рук расходились бы. Они сходятся: расхождение между руками 0.050 против 0.163 у контролей, p меньше 0.001. Все пять писцов пользуются вариантами в одних пропорциях. Таблицы были общими. Подробнее - в статье «Пять писцов, один ключ».
Что модель воспроизводит
Десять статистик одновременно: энтропию 2.17, долю словаря 0.30, долю двойников 1.2 %, их кучность 1.87, выигрыш информации на стыке 0.165, подъём y → q в 1.77 раза, концентрацию словаря, долю повторов 0.94 %, кучность 1.75 и все четыре «подписи» Парижеля - граничные статистики, которые французский исследователь предложил как критерий настоящего текста. Четыре из четырёх, без подгонки.
И контроль с другой стороны: шестнадцать чужих генераторов - самокопирование Тимма, решётки, вольвеллы, марковские цепи, двухступенчатые схемы, асемический генератор Ланзини, свежие архитектуры с памятью - через наш профиль не проходит ни один. Рвётся почти у всех одно и то же: кучность двойников.
Где модель ошибается
Честный список важнее победного. У модели двадцать открытых дефектов - измеренных статистик рукописи, которые она не несёт. Главное семейство - словарь: рукопись продолжает порождать новые формы там, где у модели словарь исчерпан. Предел локализован точно: правило сборки «слово - одна ячейка либо приставка плюс окончание» покрывает 77.7 % словоупотреблений, но лишь 36.4 % разных форм. Починка внутри класса закрывает половину разрыва; дальше нужна смена правила.
Два дефекта особенно интересны, потому что их не несёт никто из шестнадцати механизмов - зачины строк и позиционный выбор формы внутри строки. Это уже не наша ошибка, а ограничение на любой класс объяснений. Полная таблица с числами - на странице «Дефекты модели».
Почему это не расшифровка
Модель говорит, КАК сделан текст, но не ЧТО в нём написано. Мы проверили, можно ли из модели вывести ключ: решатель с ограничением на шесть таблиц вскрывает синтетический текст того же устройства с точностью 0.95, а на рукописи даёт прирост 0.04-0.07 при пороге 0.5 - под латынью, армянским, коптским, старофранцузским, каталанским, итальянским, окситанским, испанским и средневерхненемецким. Значит, рукопись - не «наш канон в точности плюс известный язык». Либо язык другой, либо ключ устроен иначе в деталях, к которым решатель чувствителен, - а он чувствителен даже к одной ошибке писца в таблице. Что это значит для шансов прочесть - в статье «Порог якоря».
Для понимания: всё сказанное - модель механизма, проверенная на статистиках, а не чтение. Удачей была бы находка самих таблиц или текста-источника; тогда модель станет инструментом чтения за часы.
Частые вопросы
Что такое вербозный шифр?
Шифр, в котором одна единица исходного текста - буква или слог - заменяется несколькими знаками. Текст от этого удлиняется, а предсказуемость следующего знака растёт - ровно то, что мы видим у рукописи.
Откуда известно, что таблиц именно шесть?
Из перебора. Меньше шести - модель не даёт нужного числа слов-двойников; перекос в использовании таблиц портит все остальные показатели. Шесть сбалансированных таблиц - единственная точка, где сходятся десять статистик одновременно. Независимо к тому же классу пришёл Майкл Грешко в журнале Cryptologia в 2025 году.
Значит, текст можно расшифровать, подобрав таблицы?
Нет. Мы это проверили прямо - решатель, который вскрывает синтетический текст того же устройства с точностью 0.95, на рукописи молчит под десятью языками. Либо исходный язык не из проверенных, либо устройство ключа отличается от нашей модели в деталях, к которым решатель чувствителен.
Чем модель ещё плоха?
У неё двадцать измеренных дефектов - статистик рукописи, которые она не воспроизводит. Главное семейство - словарь: рукопись продолжает порождать новые формы там, где у модели словарь исчерпан. Полный список с числами - на странице «Дефекты модели».