Was feststeht
Der weiche Wortzwischenraum: warum `saiin` und `s aiin` dasselbe sind und was das über die Chiffre sagt
Zwei benachbarte Wörter der Handschrift kommen im selben Buch auch zusammengeschrieben vor - anderthalbmal häufiger als der Zufall. Das gilt für alle fünf Transliterationen und beide „Sprachen“. Wir haben es mit einer eigenen Schicht des Modells reproduziert und dann entdeckt, dass wir von der anderen Seite her auf dieselbe Stelle gestoßen sind.
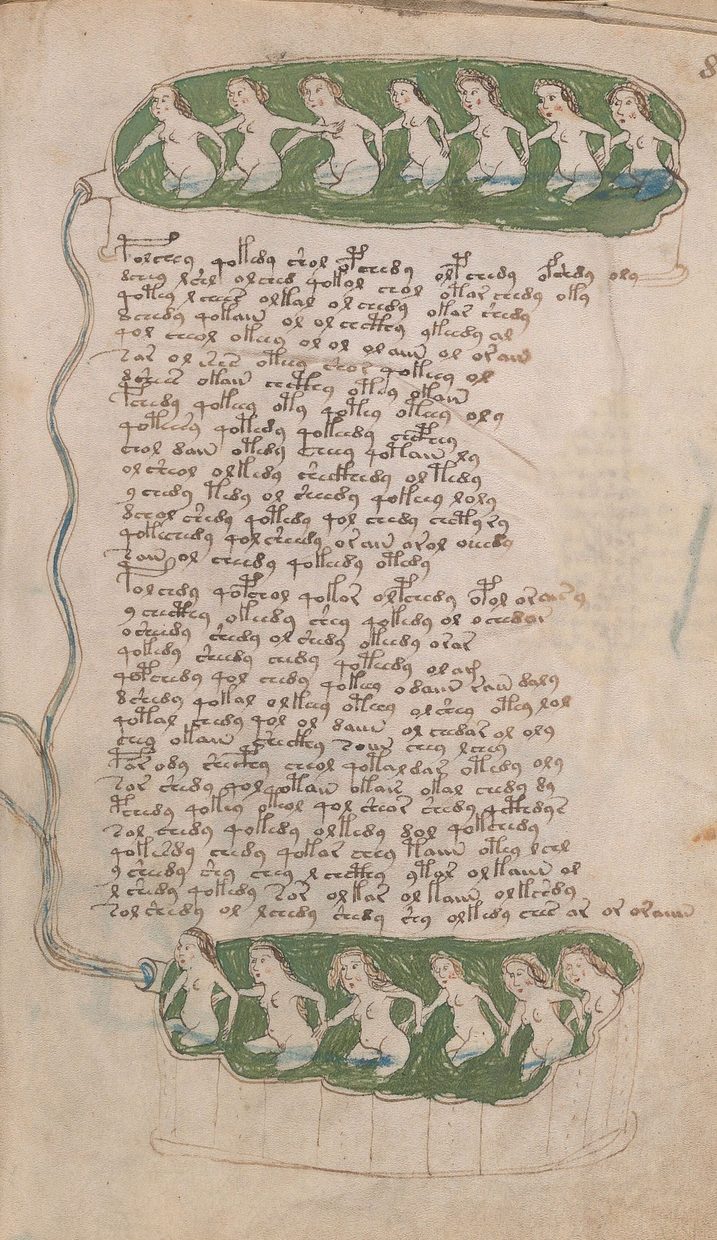
Das Wort aiin ist eines der häufigsten der Handschrift, 483 Vorkommen. Davor steht oft s: Das Paar s aiin kommt 56-mal vor. Und weitere 113-mal steht im Buch saiin - zusammengeschrieben. or aiin - 51-mal getrennt und 29-mal zusammen. ol chedy - 22 und 34. Der Schreiber wusste offenbar nicht sehr genau, wo ein Wort endet und das nächste beginnt.
Diese Beobachtung ist seit langem bekannt. Wir haben aus ihr eine messbare Größe gemacht, sie an allem geprüft, woran man sie prüfen konnte, und eines der saubersten Ergebnisse des Projekts erhalten.
Das Maß
Wir nehmen jedes Paar benachbarter verschiedener Wörter einer Zeile und fragen: Gibt es im Korpus ihre zusammengeschriebene Form als ein Wort? Der Anteil solcher Paare ist J. Das Nullmodell: die Wörter innerhalb der Zeile durchmischt. Der Überschuss Δ = J minus Nullmodell.
Die Handschrift: J 8.89 % bei einem Nullmodell von 5.16 %, Überschuss +3.73 Prozentpunkte, z +31.6. Nun die Prüfungen, ohne die die Zahl nichts wert ist.
Fünf unabhängige Transliterationen - verschiedene Leute haben verschieden entschieden, wo ein Zwischenraum zu setzen ist: ZL +3.73, Takahashi +2.37, Clastons v101 +4.67, FSG +1.78, Currier +1.23. Alle positiv, alle signifikant. Sprache A +3.14, Sprache B +3.28. Paare über einen sicheren Zwischenraum (nicht über einen zweifelhaften) +2.62. Zeilenmitte +3.52. Die zusammengeschriebene Form steht in 99 % der Fälle auf einer anderen Seite - hier hat kein Schreiber die Nachbarzeile abgeschrieben, das ist eine Eigenschaft des Systems.
Zahlen zur Grafik
| Manuskript, ZL | +3,73 |
| Manuskript, Takahashi | +2,37 |
| Manuskript, v101 Claston | +4,67 |
| Manuskript, FSG | +1,78 |
| Manuskript, Currier | +1,23 |
| Kanon vor 07.10.2026 | +0,06 |
| 8 Generatoren „Wort = Einheit“ | +0,00 |
| Kanon mit der Schicht „weicher Zwischenraum“ | +2,97 |
Wer den Effekt trägt
Ihn tragen Paare mit einem kurzen Wort. Ist mindestens ein Wort des Paares ein oder zwei Zeichen lang, liegt J bei 31 % gegen ein Nullmodell von 18 %. Haben beide drei Zeichen oder mehr, beträgt der Überschuss nur +1.04 Punkte. Die linken Glieder der wechselnden Paare sind ol, s, or, ar, o, l, r, y, qol: Bei o, l, s entfallen 65-72 % aller ihrer Vorkommen auf ein wechselndes Paar. Die rechten sind aiin, l, ar, al, chedy, r, shedy, ain: bei aiin 57 %.
Kurze Gruppen, die sowohl für sich allein gehen als auch an den Nachbarn geklebt.
Ist das normal
Wir haben 105 Texte der Epoche ohne OCR-Fehler - Latein, romanische, germanische Sprachen - mit demselben Maß geprüft. Die Handschrift steht auf dem 91.-94. Perzentil: hoch, aber innerhalb der Spanne. Einen Wechsel derselben Größenordnung zeigen die spanischen medizinischen Texte des fünfzehnten und sechzehnten Jahrhunderts in der Transkription des HSMS: de la und dela, en el und enel. Lateinische Ausgaben geben höchstens +0.61 Punkte. Die Größe an sich ist also keine Anomalie für die Schreibweise der Epoche.
Die Anomalie liegt woanders. Wir haben das Maß durch den Katalog der Generatoren geschickt. Unser damaliger Kanon: +0.06 Punkte, ein „Nein“ auf zehn Seeds von zehn. Acht Generatoren, in denen das Wort eine unteilbare Einheit ist (Selbstkopieren, Timm, Gitter, Volvelle, Schablonen, zweistufige Schemata, Zeichengedächtnis) - null. Tragen tut ihn nur eine Markow-Kette über Wörter, die auf den Wortpaaren der Handschrift selbst trainiert ist (63 %) - also eine Kopie. Stromgeneratoren, in denen der Zwischenraum ein Zustand ist, geben 11-38 %. Eine Kette dritter Ordnung über Glyphen mit dem Zwischenraum als Symbol, auf der Handschrift trainiert, 61-72 %: Die lokale Statistik der Zeichen reicht für zwei Drittel des Effekts.
Die Schicht „weicher Wortzwischenraum“
Da kein Generator vom Typ „Wort gleich Einheit“ den Effekt liefert, braucht das Modell eine Schicht, in der die Wortgrenze weich ist. Wir haben sie gebaut und nach der Regel angenommen: alle Schutzfenster unversehrt, keine der vierzehn Achsen schlechter, die Zielachse geschlossen.
Der Bau: Ein Wort, das aus Präfix und Suffix zusammengesetzt ist, wird mit einer Wahrscheinlichkeit von 0.35 als zwei Token an der Fuge der Zellen geschrieben, wenn beide Hälften selbst Formen des Lexikons der Tabellen sind; mit einer Wahrscheinlichkeit von 0.10, wenn nur die rechte es ist; andernfalls wird nicht getrennt. Das Ankleben des ersten Tokens eines Wortes an das vorige: 0.02. Trennen und Kleben verbrauchen das Budget der Zeile - die Zahl der Wörter je Zeile wächst nicht. Die Entscheidungen trifft ein eigener Zufallszahlengenerator, sodass das Modell ohne die Schicht Byte für Byte mit dem früheren übereinstimmt.
Das Ergebnis auf frischen Seeds: +2.97 Punkte bei einem Ziel von +3.73, getragen von 10 Seeds von 10, die Zusammensetzung der Paare wie bei der Handschrift. Nebenbei verbesserten sich vier weitere Achsen. Der Defekt wurde mit dem Kanonwechsel vom 7. Oktober 2026 geschlossen.
Ein wichtiger Vorbehalt, den wir damals gleich mit festgehalten haben: Ein gleichmäßiges Trennen von 10 % der Wörter liefert 97 % der Größe, aber nicht die Zusammensetzung - bei der Handschrift wechseln eigenständige Wörter, bei der gleichmäßigen Schicht ist die Verteilung zweigipflig. Deshalb ist die Schicht nach der Wortähnlichkeit der Hälften gebaut, nicht nach einem Anteil.
Derselbe Punkt von der anderen Seite
Elf Tage später prüften wir eine fremde Achse: Der Forscher Dominik hat den Zusammenhang zwischen der Klasse eines Wortes und der Klasse des nächsten Wortes gemessen. Der Kanon trägt die Größe, sogar mit Überschuss. Aber die Zusammensetzung erwies sich als anders: Bei der Handschrift stammen nur 46 % des Zusammenhangs aus Paaren „dieselbe Klasse“, beim Kanon 134 %. Die fehlende Hälfte sind Übergänge zwischen verschiedenen Klassen, und das sind genau unsere Paare: s aiin 54-mal bei der Handschrift und 0 beim Kanon, or aiin 54 und 0.5, r aiin 22 und 0. Der Kanon schreibt saiin und raiin nur zusammen; einzelne s hat er 4 gegen 270, einzelne r 5.5 gegen 137.
Zwei unabhängige Achsen - der Wechsel und die Klasse des Nachbarn - sind an derselben Stelle angestoßen. In den Tabellen, auf denen das Modell steht, kodiert eine Form in verschiedenen Rollen verschiedene Buchstaben: ol als Wort ist ein Buchstabe, als Präfix ein anderer. Die Handschrift verhält sich, als hätte sie ein gemeinsames Inventar kurzer Gruppen für alle Positionen: s, r, o, l - Wort und Wortanfang zugleich. Das ist eine Hypothese über die Zusammenbauregel, und prüfen muss man sie mit einem Generator, nicht durch Nachstellen der Gewichte: Wir haben direkt gezeigt, dass ein stärkeres oder schwächeres Priming die Zusammensetzung nicht ändert.
Zum Verständnis: Alles oben betrifft die Form der Schreibung, nicht die Bedeutung. Ein Erfolg wäre ein Generator mit gemeinsamem Inventar, der den Wechsel, die Klasse des Nachbarn und die Tabelle „Gruppe plus aiin“ bis auf den Faktor zwei wie bei der Handschrift liefert, ohne eine der früheren Achsen zu verlieren. Dann ändert sich die Zusammenbauregel des Wortes im Modell - und mit ihr vielleicht der Bau des Schlüssels, den der Löser sucht.
Häufige Fragen
Was bedeutet Wechsel von Zusammen- und Getrenntschreibung?
Wir nehmen zwei benachbarte Wörter einer Zeile, etwa s und aiin, und sehen nach, ob das Korpus das Wort saiin enthält. In der Handschrift machen solche Paare 8.89 Prozent aus, gegen 5.16 bei einer Durchmischung der Wörter innerhalb der Zeile. Der Überschuss beträgt +3.73 Prozentpunkte, z +31.6.
Ist das nicht ein Artefakt der Transkription - jemand hat die Zwischenräume falsch gesetzt?
Nein. Der Effekt hält auf fünf unabhängigen Einteilungen in Wörter - ZL, Takahashi, Clastons v101, FSG, Currier - in beiden „Sprachen“ und bei drei Händen. Die zusammengeschriebene Form steht in 99 Prozent der Fälle auf einer anderen Seite - das ist kein lokales Abschreiben.
Kommt so etwas in gewöhnlichen Texten vor?
Ja. Unter 105 Texten der Epoche steht die Handschrift auf dem 91.-94. Perzentil - innerhalb der Spanne. Einen Wechsel derselben Größenordnung zeigen die spanischen medizinischen Texte des fünfzehnten und sechzehnten Jahrhunderts: de la und dela, en el und enel. Anomal ist nicht die Größe, sondern dass kein Generator sie liefert, in dem das Wort eine unteilbare Einheit ist.
Was hat das mit dem Lesen zu tun?
Unmittelbar nichts. Aber es ist einer der wenigen Fälle, in denen zwei unabhängige Achsen auf denselben Punkt im Bau der Chiffre gezeigt haben: Kurze Gruppen wie s, r, o, l gehen sowohl als eigenes Wort als auch als Wortanfang. Trifft das zu, muss die Regel für den Zusammenbau eines Wortes im Modell geändert werden.