锚点与寻找密钥
锚点阈值:破解手稿的密码需要多少已知文本
我们在一个密钥已知的模型上算了这个数。完整的密钥能读出 96.9 % 的文本。要复原它,需要大约六百个拉丁词的对齐样本。所有已知的提示,末页上的几行字、月份名称、一圈题记,都小两到三个数量级。
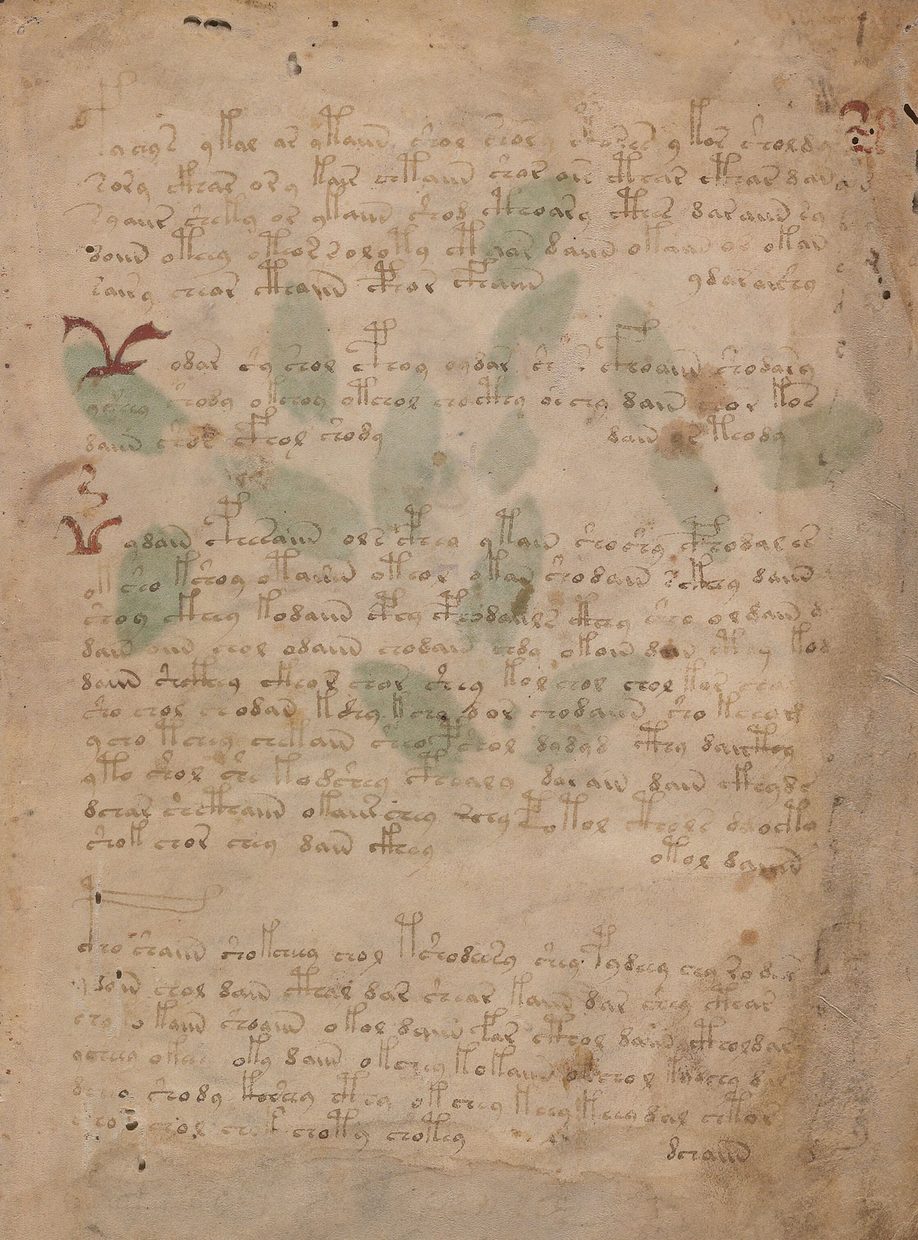
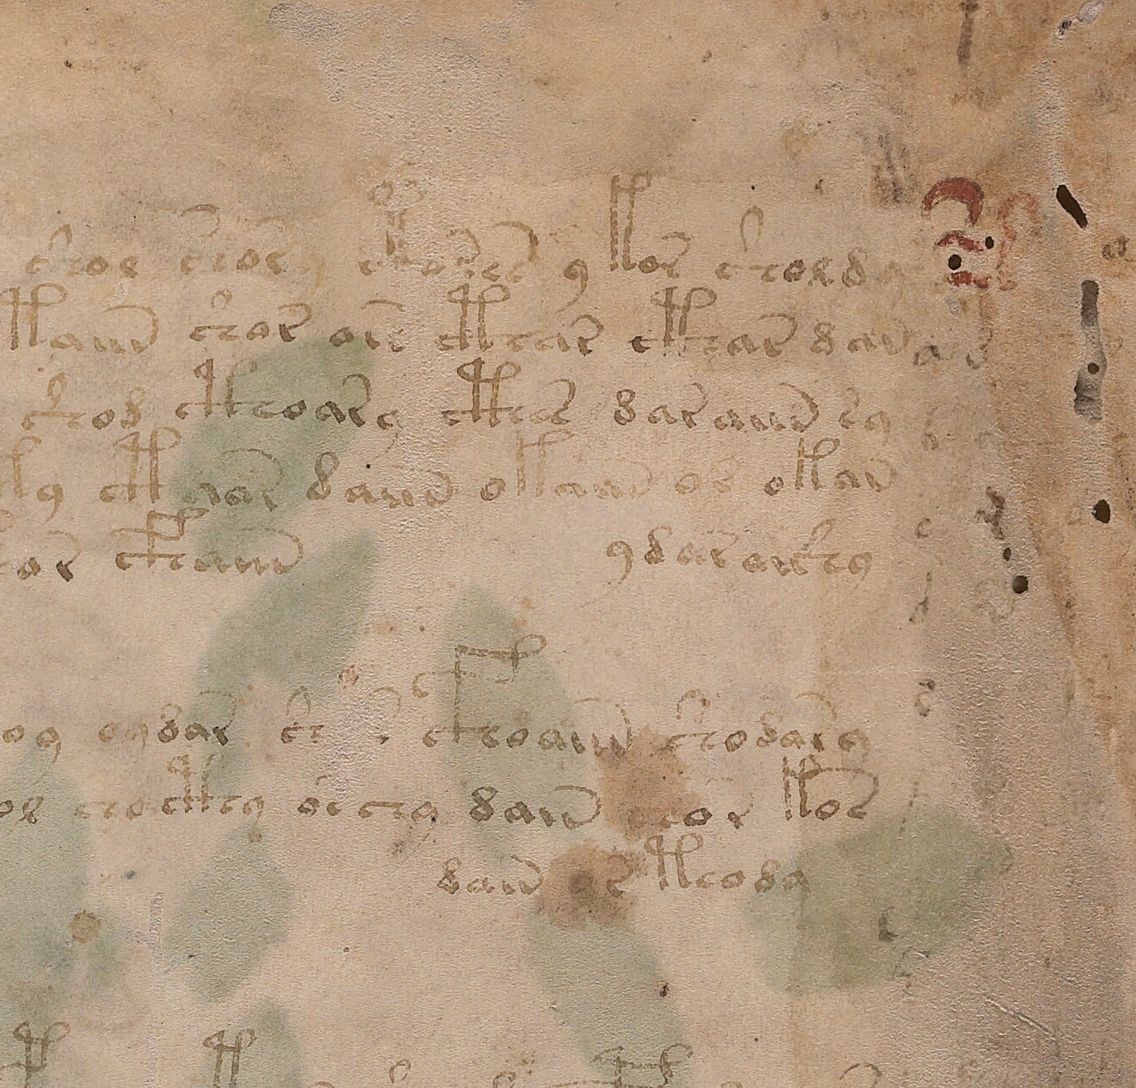
每一个坐下来研究伏尼契手稿的人,迟早都会去找锚点:一个知道写了什么的地方。末页 f116v 和它那几行 近乎拉丁文的字。由后来的手写进黄道带的月份名称。植物旁边的题记。三十个标签组成的圆环。似乎只要抓住 一个,其余的就会被牵出来。
2026 年九月,我们算了算实际上需要多少。答案改变了项目的策略。
密钥已知的实验
我们有一个机制模型,在它上面可以做手稿上做不了的实验:用已知密钥加密 拉丁语,然后“忘掉”密钥,尝试凭给定大小的锚点把它复原。五个种子,对照通过。
弄清楚的第一件事:同音替代,即一个字母有若干种写法,不是障碍。完整的密钥能读出 96.9 % 的词次;解析 的平均歧义只有 1.5。如果密钥在手,文本几乎能整篇读出来。
障碍是锚点的体量。要复原一半的密钥,需要手稿 2 500 个完美对齐的词。要复原 80 %,需要两万个。一百个 词给出密钥的 20 %,而且是在理想条件下,没有一处对齐错误。
换算成拉丁词,考虑到密码把词膨胀 1.24-1.53 倍,2 500 个词次的阈值就是源文本的 530-660 个词。按同一 估算,手稿的全部明文是 8-10 千个拉丁词。一篇被辨认出来、放在自己位置上的五百来词的段落,能读出这 本书的 60 %。
图中数据
| 100 | 20% |
| 2500 | 50% |
| 20000 | 80% |
手头有什么
| 锚点候选 | 大小 | 占阈值的比例 |
|---|---|---|
| f116v 的几行字 | 约 8 个词 | 0.3 % |
| 黄道带上的月份名称 | 约 10 个词 | 0.4 % |
| 一圈题记 | 约 30 个标签,各 2 个字母 | 1 % |
| f1r 上的字母列(十七世纪) | 几十个符号 | 不到 1 % |
所有已知的候选都比阈值小两到三个数量级。追猎现实尺寸的明文线索(crib)是徒劳的,而这还是上限估计, 是在理想对齐之下。
从内部破解
如果没有锚点,剩下的是无锚点的破解:挑选密钥,使文本变得像一种语言。简单密码就是这样被破开的。 第一次尝试,还在夏天,结果是否定的:明文的字母序列在词的组成部分这一层活不下来,真正的手稿给出的 似然比打乱过的还差(每个字母 -2.95 比特,对比 -1.81)。
秋天我们造了一个更聪明的求解器,它受密钥构造的约束:六张表、三个位置、候选语言的语言模型。在同一 构造的合成文本上,它从零开始复原密钥,准确率 0.95,三次中三次。这很重要:工具是管用的。在手稿上: 似然增益 0.04-0.07,阈值 0.5。一片寂静。
我们给罕见形式的尾部加上掩码(让 30 % 的损坏词不来碍事)又做了一遍:寂静。又换了十种语言:拉丁语、 亚美尼亚语、科普特语的两种方言、古法语、加泰罗尼亚语、意大利语、古奥克语、西班牙语、中古高地德语。 在测试台检验力为两次中两次的情况下,手稿给出的是从 -0.07 到 +0.13,阈值 +0.15。对十种语言全部,这 都是对“标准模型的机制分毫不差,再加一种语言”的否定。
什么让求解器失明
这里重要的是不要高估结论。“求解器沉默”意味着两件事之一:要么语言不在名单上,要么密钥的构造与模型 不完全一样。我们检验了求解器对偏差有多宽容,答案令人清醒。
每一部分里抄写者在表中出一个错,准确率就跌到 0.20。九张表而不是六张,0.09。30 % 的字母有同音替代, 0.08。不写元音的书写、语言混用、缩写,求解器就失明。哪怕是对明文轻微的故意损坏,20 % 的情况下混淆 相似的元音、10 % 的空符,也把它压到 0.11-0.20。它唯一撑得住的是半页处更换表(0.51)。
因此,“否定”的结论对一位用六张表的细心抄写者成立。对一位粗心的,而中世纪的加密者正是这样的人,需要 一个宽容的求解器。我们正在造它:在带空符的合成文本上,宽容版本已经有了检验力(准确率 0.561),在表中 有错的情况下,三个种子中两个。下一步是按文类的词而不是按字母工作的求解器;它现在正在计算中。
这改变了什么
锚点阈值关闭了一整个方向,即寻找短小的提示,又打开了另外三个。
密钥作为实物。 六张表就是一两页羊皮纸,414 行对应关系。这样的文件是能留存下来的:从 1401 年的 曼托瓦到米兰文书处 287 把密钥的那本书。手稿的线索穿过写给 Kircher 的信件,那里记载了两件遗失的物品。 关于这一点,见《寻找密钥》。
段落。 不是一个词,不是一行,而是整篇来源文本,按条目长度的顺序辨认,这是一个能在密码下存活的量。 工具已就绪,并在 182 篇文本上检验过;关于这一点,见《第二扇门》。
正确的模型。 不是算力的极限,而是模型的极限:冗长密码的短文本容许许多同样可信的密钥,只有当密钥 模型在细节上正确时,才能选出正确的那把。寻找这些细节,就是模型的开放缺陷和宽容的求解器。
说明:以上全部关乎手稿按十项统计量所属的那一类密码。若要算成功,需要三者之一:带表的文件、被辨认 出来的段落,或者一个让求解器在手稿上给出它在合成文本上所给结果的模型。
常见问题
密码分析里的锚点是什么?
一段既知道密文写法、也知道原文写法的文本。经典的例子是签名或日期。有了锚点,就能复原密钥的一部分,再把阅读往外扩展。
为什么末页 f116v 上的几行字帮不上忙?
它们大约八个词。六张表的密钥哪怕只复原一半,所需的阈值也是手稿约 2 500 个对齐的词。即使在理想条件下,一百个词也只给出密钥的 20 %。
不能干脆用计算机穷举密钥吗?
我们做了。限定为六张表的求解器能从零开始破解同一构造的合成文本,准确率 0.95。在手稿上,它在十种语言之下保持沉默。这是信息和模型的极限,不是算力的极限。
那么什么能改变局面?
三样东西。带表的文件本身,即实物密钥。一篇被辨认出来、放在自己位置上的五百来词的来源文本。或者一个正确的密钥模型,在它之下求解器会重新起作用,我们正在做这件事。