差一步的发现
差一步的发现:二十次谜底仿佛近在一步之遥
一部通过了三道检验的历书。一本余量只有百分之零点几的 1494 年的书。一个在黄道带上盲法重复出来的信号。每一个这样的情形,我们都按事先写好的规则走到了底,每一个都关闭了。这里把它们收在一起,带着数字,也带着当时欠缺的东西。
2026 年十月,我们定了一条规则:给每一个结论写一条“差一步”的附注,哪个小小的位移会让结果好上几倍, 用哪个测试能诚实地检验它。结果发现,这样的附注整个项目期间一直在积累,只不过以前住在日志里。这里是 二十个主要的,从最有名的到最新的。
读表的规则:“离得多近”,是事先设定的阈值和实际得到的结果;“什么把它杀死”,是关闭这个情形的检验; “什么能带来成功”,是我们命名的位移和它的检验状态。
五个几乎成了论文的
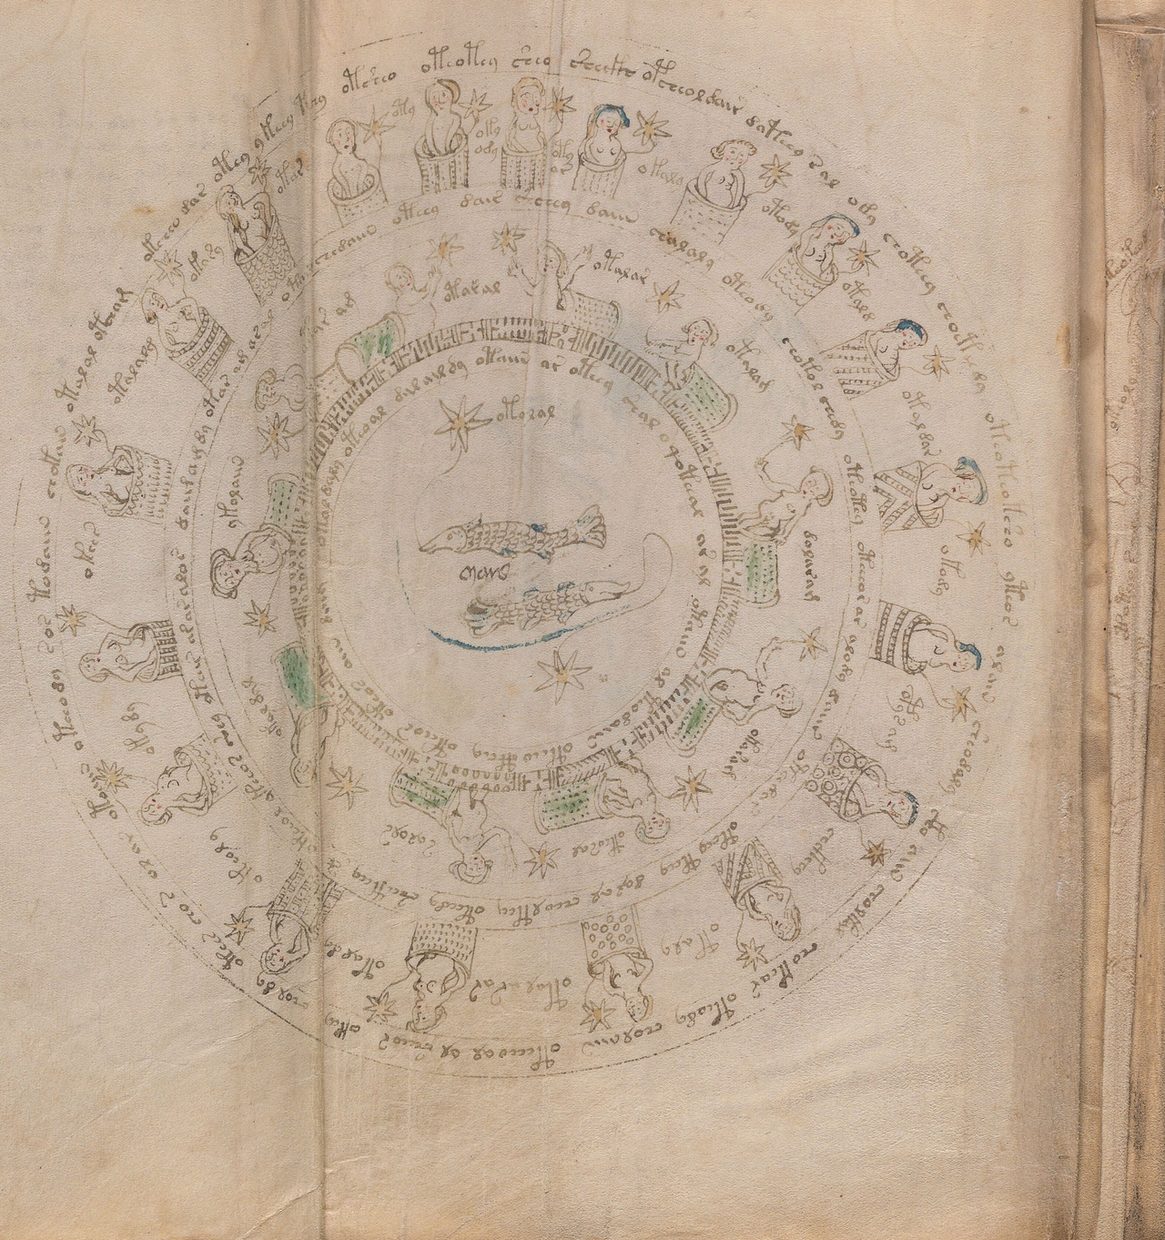
莱里达历书,1524 年。 如果黄道带的标签是一年中的日子,那么环的周围可能站着圣徒。我们跑了十九部 教会历书,十二部南法的,七部伊比利亚的,预注册了这一族,并做了多重比较校正。莱里达排在第一:p 0.0020, 阈值 0.0022。在独立转写上的复现:p 0.0040,通过。留出样本:通过。三道关口过了三道。把它杀死的是按 时代错误做的分解:承载信号的是 1438 年之后,也就是羊皮纸放射性碳测年之后才被封圣的圣徒。吻合的是 历书的结构,不是内容。十五世纪莱里达的完整圣徒历在物理上并不存在。分析见 单独的一篇文章。
阿方索十世的宝石书。 外部清单搜寻计划的第一个预注册信号:p 0.008,发现阈值 0.005,而且位移的峰值 恰好在 23,与黄道带信号同一位置。把它杀死的是我们自己的解析器:来源的对齐在漂移。按 1881 年版本核对过的 修正版(名字 86.5 % 对 62.5 %)给出 p 0.077,峰值消失了。按中心指标排的顺序,同样是零。教训写进了规则: 来源的对齐要在测试之前用独立的证人核对。
Ketham 的书,1494 年。 按条目长度顺序搜寻来源文本时,1 104 对中唯一的一次响应:距离 0.2119,零模型 的最小值 0.2147,余量 0.14 %。把它杀死的是带另一个零模型的确认程序:这一部分的区块顺序与置换无法区分 (0.015,零模型 0.033,而在有真实对应的合成文本上是 0.080),同一汇编的拉丁文版在任何一个目标上都没有 过阈值。完整的故事见《第二扇门》。
位移 23。 水仙女的属性与 al-Biruni 的阳度和阴度表在位移 23 个位置时吻合。盲法复现:p 0.0088,峰值 恰好在 23;相对于同一组度数另外两种标注的特异性:零。这是真实的信号。把它杀死的是推广:从巨蟹到射手的 六个星座上完全是零;信号只局限于双鱼、白羊和金牛,而且与“明半与暗半”的划分无法区分。能带来成功的是 第三位编码者和一份外部的度名清单,但 1488 年的 Astrolabium 清单在位置上对不上。详见 《按度数划分的黄道带》。
1424 年的米兰密码。 放射性碳窗口之内第一份音节书写的样本:一套 150 个音节的音节表,带代码组和罗马 数字串,由 Mark Knowles 根据佛罗伦萨文书处的截获信件复原。这修正了我们对那个时代的认识:以前我们以为 音节符号从 1450 年代才进入密码。把它杀死的是轮廓:在拉丁语上这把密钥给出的熵是 3.86 和 3.55,而手稿的 窗口约为 2.2。结论不依赖密钥转录的变体。详见《1424 年的米兰密码》。
还有十五个
| 什么几乎成了 | 离得多近 | 什么把它杀死 |
|---|---|---|
| 但以理解梦书作为 Q20 的来源:292 条对 292 个段落 | 数量的吻合精确 | 顺序不吻合(+0.011,检验力 +0.62) |
| 语言空角里的吉兹语 | 2.671 比特,边界 2.60,差了 0.07 | 语料的人为产物:92% 的词把词分隔符当成了音节;干净语料上 +0.16…+0.30,费德尔字符下 +1.3 |
| Caspari-Faccini 密钥(Max Planck,2025) | 胜过 200 次随机置换,p 0.005 | 伪词库读起来几乎像意大利语,等体量的拉丁语读得更好(0.903 对 0.658),62 % 的词元读不出来 |
| Zandbergen 的锚点:药用版面 f102r2 的根在草药部分里盲法找到 | 偶然为 6.25 %;2025 年的清单复现 22/28 | Knowles 的清单不能复现(3/21),在片段标签的层面没有关联,检验力 1.00 |
月份名称:octembre 偏北,abril 偏南 | 最好的书写传统 10 个里 5 个软吻合 | 四个有争议的形式:全部 25 种书写传统都是零;没有特异性 |
| 历算的朔望月对 f67r2 的 12 个月亮 | 12 个里 10 个吻合 | p 0.0855,阈值 0.01;参照本身退化:全部 19 个黄金数给出同一行 |
| 叠音节作为药书体裁的指纹 | 三个传统:亚美尼亚、奥斯曼、科普特 | 在手稿里这是相邻词的连写重复,是模型的缺陷,不是体裁 |
| 换表的标准模型上的行首圈 d → q → y | z +3.63,十个候选中的一个 | 十次置换的平均值 -0.5:置换的运气 |
| 改一个符号的重复 | 过了除一条以外的全部轴:0.0307,阈值 0.032 | 计算之后把参数往阈值上凑是不允许的;改动撕裂了邻词的接缝 |
| 段落边界上词尾的更换 | z 1.79,阈值 2 | 用三行的窗口、检验力 10/10:z 0.58,没有更换 |
| 按序列化排的页组漂移 | 181 440 个里排第 56 | 对齐靠的是各部分的构成;平价未通过 |
| “词的类别 - 下一个词的类别”轴 | 标准模型承载量值 | 构成不同:手稿里一半的关联是 s aiin 这样的断开,标准模型里为零 |
| 按 LSA 排的对开页顺序 | 我们 Q13 的最佳顺序与别人的一致 | 相对于零模型不显著(p 0.81);零模型没有检验力 |
| Bourdeau 的 37 轴电池 | 标准模型优于所有候选,22 个吻合对 16 个 | 承载不了词汇的四条轴,同一族缺陷 |
| 在带抄写者错误的合成文本上的宽容求解器 | 有空字符时有检验力(0.561),表中有错误时 3 颗种子里 2 颗 | 手稿在 11 种语言下都是反对;对同音替代,求解器在任何模型下都是盲的 |
三个教训
第一。连过三道形式上的关口,不是证明。莱里达吻合的是结构,不是内容,而这只有通过按时代错误做分解才 弄清。现在任何量值上的吻合都伴随着构成的核查:究竟是什么在承载信号。
第二。百分之零点几的余量,是启动带新零模型的确认程序的理由,而程序要在继续往下看之前写好。Ketham 当晚就关闭了,正是因为程序事先就准备好了。
第三。真实的信号与对阅读无用是相容的。位移 23 真实而局限。Zandbergen 的锚点真实而孤单。叠音节真实, 而且由机制解释。项目的第一规则(№1),巧合不等于释读,就诞生于这些情形。
登记簿继续在记:每一个新结论都得到一行,带数字、位移和检验的办法。关闭的差一步没有新论据不会重开。 带测试编号的完整清单在《数据与代码》页面的复现材料中。
常见问题
你们把什么叫作差一步的发现?
一个通过了部分事先设定的阈值、或者离阈值只差很小一点的结果,随后被诚实的检验关闭。这不是失败,也不是胜利,这是一张边界地图:方法在哪里敏感,在哪里说谎,还缺什么。
为什么你们不靠拟合把这些情形做成结果?
因为项目的规则禁止“重复到出想要的结果为止”。每一个位移都在看数据之前命名,用一个新的预注册测试检验一次,结局记录在案。否则二十个差一步里的任何一个都能被做成轰动新闻。
哪一次差得最近?
按形式上的关口,是莱里达的历书:Bonferroni 校正、在独立转写上的复现、留出样本。按数值上的余量,是 Ketham 1494 年的书:离偶然阈值 0.14 %。两者都已关闭。
差一步的发现里有真实的信号吗?
有。黄道带上的位移 23 经盲法复现而且有特异性,但只局限于三个星座。Zandbergen 在药用版面与草药部分之间的锚点经盲法复现,但测试所依据的词对清单后来证明不合用。真实的信号与对阅读无用,并不互相排斥。