差一步的发现
亚美尼亚线索:我们如何用四种办法关闭这门语言,又在路上找到了什么
手稿是亚美尼亚语的版本立足于两件事:相像的字母和来自东方的草药。我们检验了文本的结构、按字体和按真实手稿检验了符号的形状、做了盲法测验,得到四个零。然后手稿的叠音节把我们引向一部十五世纪的药书和三个独立的传统。结果这是另一种性质的差一步。
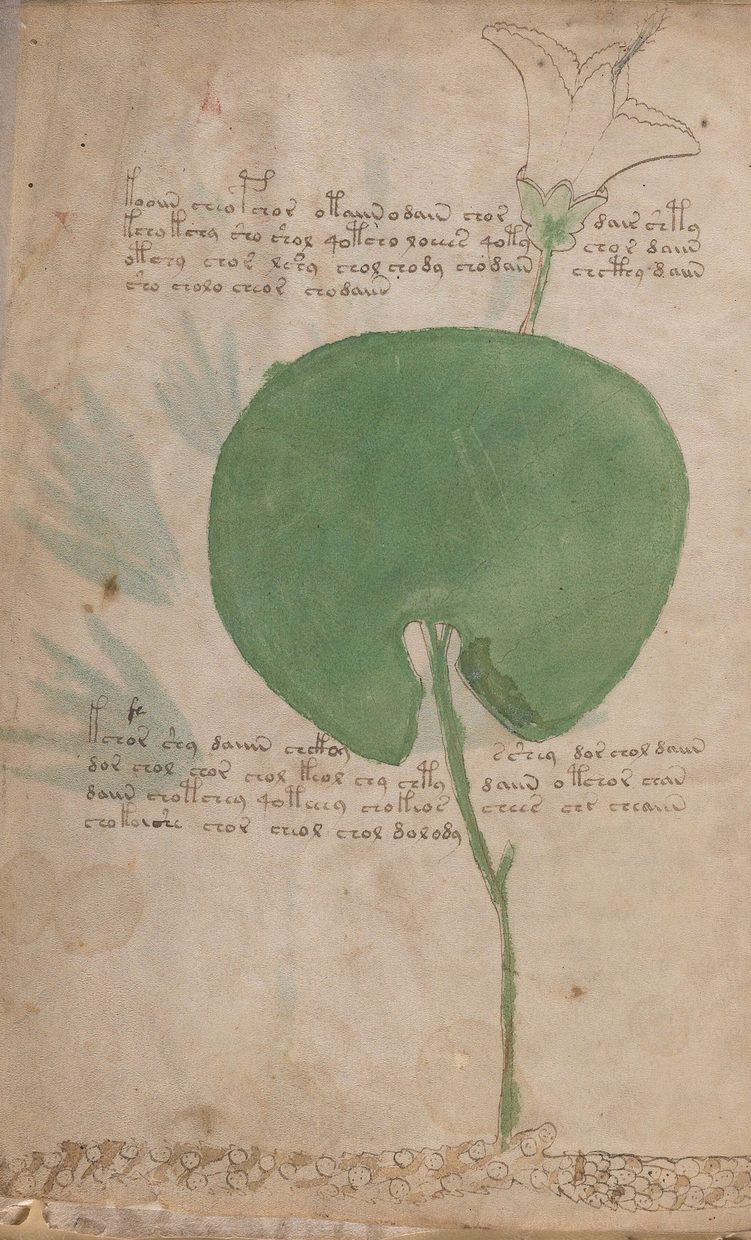
伏尼契手稿的亚美尼亚版本,属于靠两条论据活了几十年的那种:某些符号像亚美尼亚字母,而草药部分的 植物里有东方的。论据很弱,但项目的规则是先把版本发展起来,再做判断。2026 年八月,我们沿四条独立的 渠道发展了它。四条全给出零。而在路上找到了一样我们并没有在找的东西。
第一条渠道:文本的结构
如果手稿是我们的密码之下的亚美尼亚文本,它的统计指纹就应当比拉丁语的指纹更接近手稿。我们取了两个 语料库:五世纪的古典亚美尼亚语(393 千个字母)和 Amirdovlat Amasiatsi 十五世纪的药书(959 千),后者 加倍重要,因为药书是我们认为属于手稿的那个体裁的标本。
等体量下的六轴电池:亚美尼亚语过一条,拉丁语过三条。双生词聚集度 1.44-1.51,双生词 2.5-2.9 %。 字母表投影的对照(38 个字母对 22 个)解释不了差距,尽管差距不大。支持者读作植物名的词 kchor,出现 19 次,在 19 种不同的植物上:一种植物的题签不会这样表现。凭一个指纹我们不会否定一门语言:这是四个零 里的第一个,不是裁决。
第二条渠道:按字体的字母形状
手稿的符号与亚美尼亚字母有多像?我们按字体比较了它们,亚美尼亚、拉丁、希腊、西里尔、格鲁吉亚,判据 在运行之前设定。亚美尼亚语确实比拉丁字母、希腊字母和西里尔字母更近(p 0.000)。但格鲁吉亚语 mkhedruli 恰好同样近:0.749 对 0.754,p 0.901。这是圆体草书这一类的性质,不是亚美尼亚语的。最好的十对 里有九对只有通过旋转或镜像才吻合。
第三条渠道:按真实手稿的字母形状
字体是理想化。我们从同时代的真实手稿里裁出 300 个片段:来自 1455 年和 1475 年两部抄本的亚美尼亚 bolorgir,恰好是放射性碳的窗口,以及十五世纪的对照:拉丁 bastarda、希腊小写体、格鲁吉亚 mkhedruli。 手稿取两张页,每种“语言”一张。裁剪是机械的,判据在数据之前,对比度做了归一化,以免拍摄风格泄露 来源。
信号反转了。亚美尼亚语成了最差的:0.788,拉丁语 0.792,格鲁吉亚语 0.796,希腊语 0.810。按字体的相似 是字体的性质,不是字母的。
第四条渠道:盲法测验
最后一项检验是不知道假说的人眼。三十道题,每道八个选项,每种文字两个,匿名化的片段,可以选至多三个 或者回答“都不是”。计分在作答之前冻结。零模型下的选择:每种文字 25 %。结果:亚美尼亚语 28.1 %,拉丁语 28.9 %,希腊语 21.9 %,格鲁吉亚语 21.1 %,p 0.342。“都不是”出现在 30 道题里的 11 道。微弱的领先者是 拉丁语,与另一个测试同调,在那里手稿符号的形状与拉丁缩写的古文书学吻合。
四条渠道,四个零。亚美尼亚语关闭了。
图中数据
| 渠道 2:符号与字体的相似度 - 亚美尼亚文 | 0.749 |
| 渠道 2:符号与字体的相似度 - 格鲁吉亚文 | 0.754 |
| 渠道 3:与真实 15 世纪抄本的相似度 - 亚美尼亚文 | 0.788 |
| 渠道 3:与真实 15 世纪抄本的相似度 - 拉丁文 | 0.792 |
| 渠道 3:与真实 15 世纪抄本的相似度 - 格鲁吉亚文 | 0.796 |
| 渠道 3:与真实 15 世纪抄本的相似度 - 希腊文 | 0.810 |
| 渠道 4:盲测,人工选择,% - 格鲁吉亚文 | 21.1 |
| 渠道 4:盲测,人工选择,% - 希腊文 | 21.9 |
| 渠道 4:盲测,人工选择,% - 亚美尼亚文 | 28.1 |
| 渠道 4:盲测,人工选择,% - 拉丁文 | 28.9 |
路上找到了什么
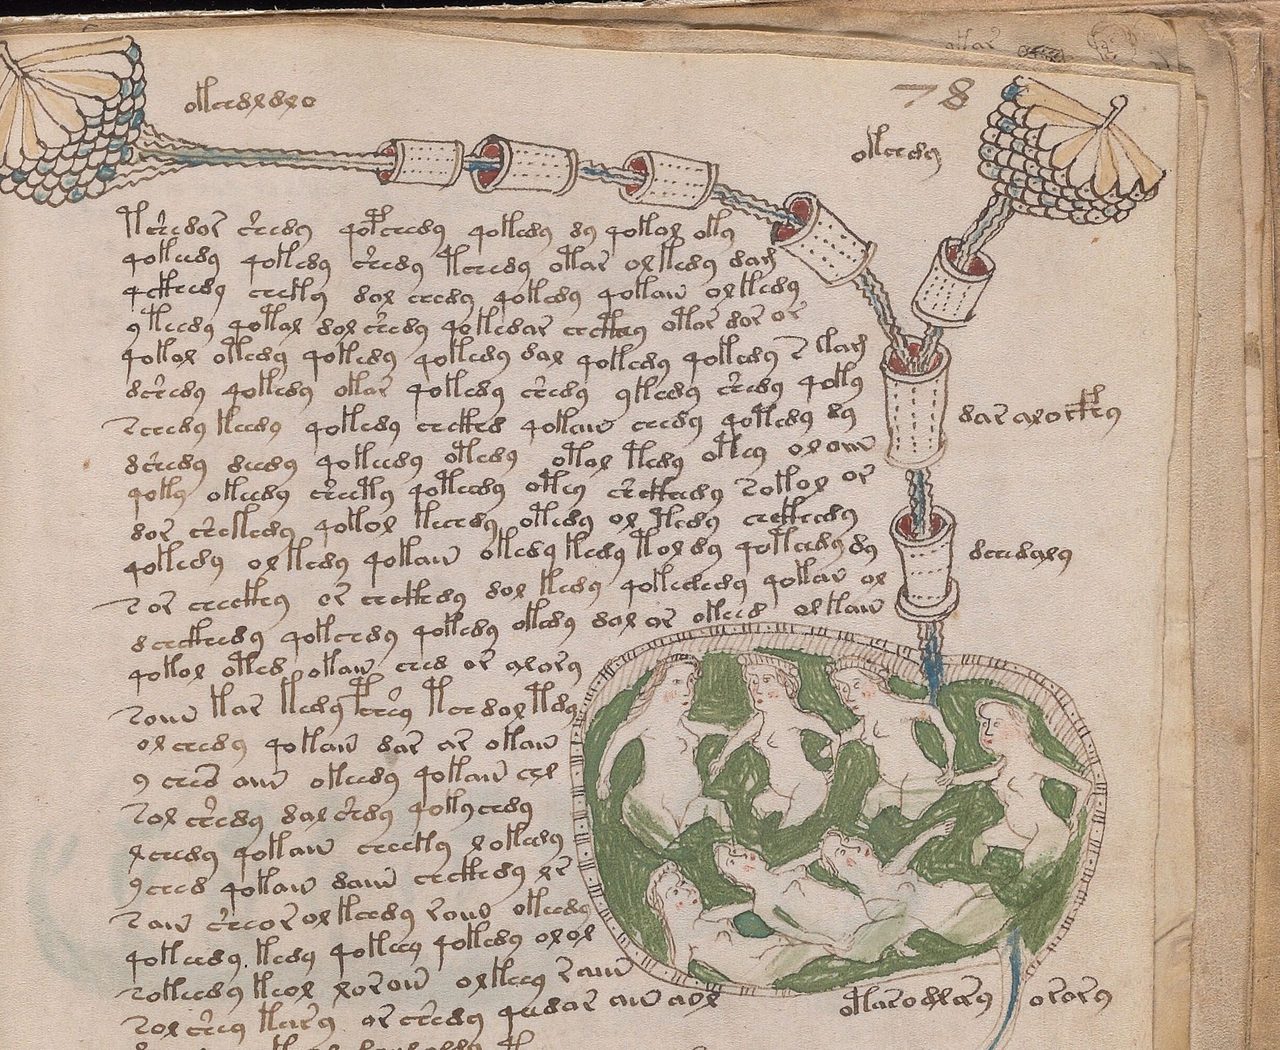
在第一条渠道运行的时候,我们在分析 f78r 页上两条藤蔓旁的题签,并把其中一条 oteoteotsho 跑过了 57 个 语料库。整个词哪里都没找到。但它的核心 ote-ote,一个重复的音节,恰恰在 Amirdovlat 那里领衔榜单: 每千词 1.34,而在五千词以上的语料库里没有一个超过 0.42。而且这些是阿拉伯语词根的叠音药名。
接下来是检验这不是亚美尼亚语的特点。拉丁文的 Antidotarium 对三字母音节给出同一水平:0.53 %。补充 语料之后,同样的词在奥斯曼人那里找到了,hashas、mermer、bulbul、zemzem,在科普特人那里也 找到了。三个独立的传统。而奥斯曼普通文学文本的密度是 0.24,药书是 1.34。体裁的特征,不是语言的: 药书喜欢叠音的名称。
手稿的数字:带叠双符号的类型 2.04 %,带叠三符号的 0.18 %:药书的带,是散文的三倍。全部 14 个三重叠音 的类型是同一个窝:daldal、kalkal、oteotey。我们把它记为线索:叠音节是体裁的指纹。
另一种性质的差一步
线索活了一个月。九月,我们换了一种方式测量同一个量,作为带叠双符号的类型的占比,olol、arar,并 让它跑过生成器。手稿 1.77 %,标准模型 0.25-0.37 %,五颗种子里五颗都低于目标的一半。这是模型的缺陷, 而且是另一个缺陷的亲戚,相邻词的重复:手稿里两个相邻的词比模型里更常相同,而其中一部分重复是连写的。 叠音节就是连写的相邻重复。不是明文的体裁,而是书写的性质。
线索就这样关闭了:不是因为与药书的吻合是假的,而是因为手稿有一个更近的解释,根本不需要语言。这是 一种特殊性质的差一步:正确的观察,正确的体裁,错误的解释层次。
说明:四个零关闭了亚美尼亚语作为我们这类密码之下的明文语言;草药部分的东方植物既不因此得到解释, 也不因此被否定。若要算成功,需要的不是一个相像的字母,而是一段在密码之下能给出手稿轮廓的亚美尼亚 文本,这样的文本没有找到。
常见问题
为什么亚美尼亚语竟会被考虑?
因为手稿的某些符号与亚美尼亚字母外形相似,也因为草药部分里有东方的植物。这是弱论据,但项目的规则是先把版本发展起来,再做判断。
字母的相似是怎么检验的?
三种办法。按字体:亚美尼亚语确实比拉丁字母和希腊字母更近,但格鲁吉亚语 mkhedruli 恰好同样近:这是圆体草书整体的性质。按同时代的真实手稿:信号反转了,亚美尼亚样本最差。用盲法测验:选亚美尼亚语的比例处在偶然水平。
什么是叠音节,它们为什么重要?
像 ote-ote-y 或 dal-dal 这样一个音节重复两次的词。手稿里它们明显多于散文。我们在 Amirdovlat 十五世纪的药书和奥斯曼人与科普特人的药名里发现了同样的密度:这是药书体裁的特征,不是语言的。
结局如何?
语言被四个零关闭。而叠音节后来证明不是体裁的指纹,而是机制的后果:在手稿里这是相邻词的连写重复,我们的生成器给得不够,这是模型的缺陷,另一个已知缺陷的亲戚。