已确立的结论
行与行彼此记得:循环 d → q → y 与对一整类解释的约束
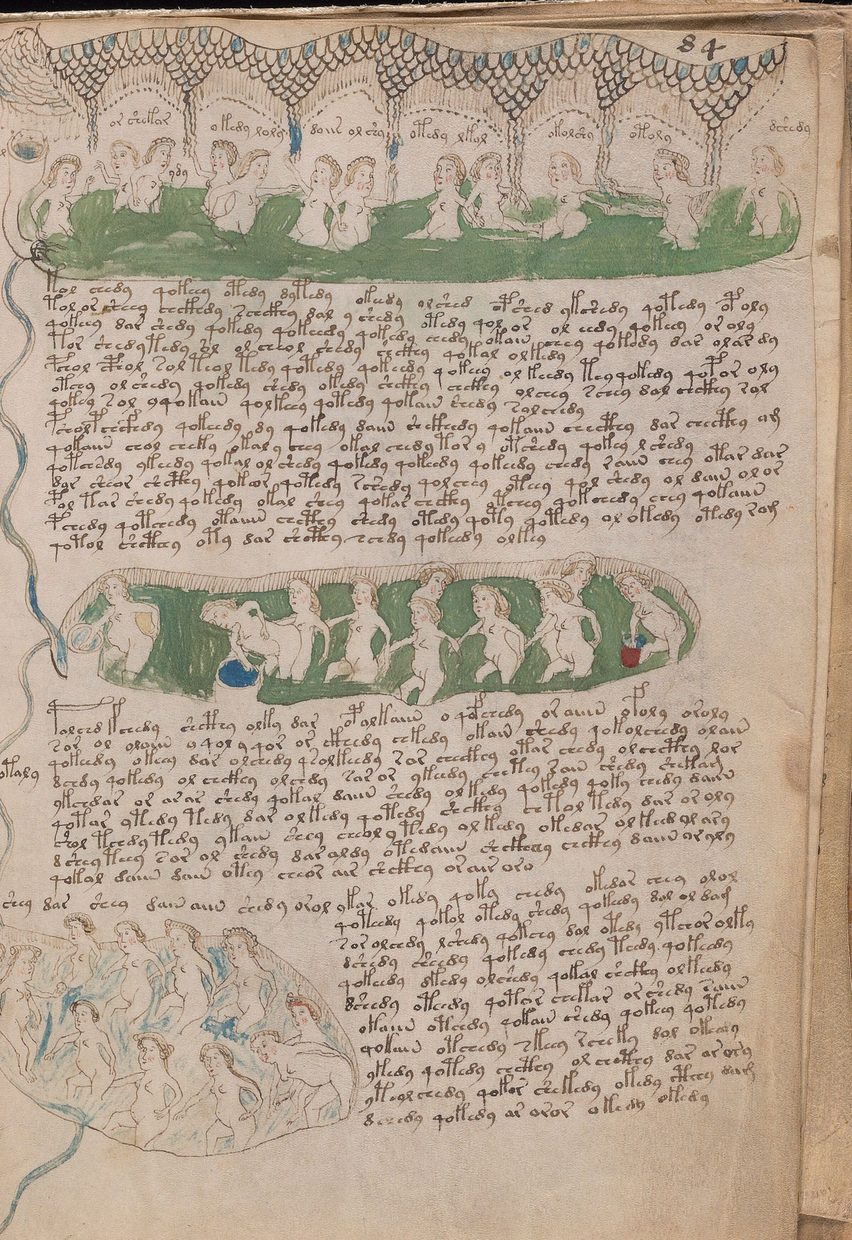
手稿中一行的第一个词回避上一行的第一个词,而且行首有一个有方向的循环。我们在两份转写上测量了它,用重新排版复核了它,又让它通过了十六个生成器。没有一个能承载它,包括我们自己的。
2026 年八月,某个论坛上出现了一条声明:有人测得手稿相邻各行的第一个词彼此相关,“z 约为 25”。没有 代码,没有论文,没有数据。我们没有等,自己做了测量:自己的定义,自己的对照,在拿到数据之前预注册。 走廊对上了。然后故事走向了我们没有料到的地方。
回避
定义很简单。行首是一行第一个词的第一个字形单位。度量是同一页内一行的行首与下一行的行首之间的互信息。 零模型:行首在页内打乱,一万次。
手稿:0.1683,零模型为 0.0599,z +23.95。独立的 Takahashi 转写:z +24.17。方向是回避:相邻两行行首 相同的情况占 6.88 %,期望值是 13.54 %。抄写者不以上一行的开头方式开始新的一行。
对照。去掉各段的首行,z +22,可见这不是标题行的效应。行尾,z +1.16,p 0.13:效应专属于行首。切成行的 Cato 拉丁文,+0.95,测试台干净。检验力:植入 5 % 的效应,测试台 20 次中 20 次捕获,误报 20 次中 0 次。
语言 A 给出 z +16.8,语言 B +16.5,与“A 比 B 更严格”这条通则合拍。
不只是禁令
下一个问题:这只是对重复的禁令,还是不同行首之间有偏好?我们去掉对角线,即“同一行首”的词对,重新 计算。不含对角线的互信息 0.3197,对比 0.2307,z +19。偏好是有的。效应是局部的:在滞后 1 上巨大, 滞后 3 上几乎为零(+1.78),滞后 4 上为零。它在符号类别的层面也能看见,“绞架字符”“长凳字符”和其余 (z +15)。
还有对我们的模型来说第一个不愉快的结果:生成器只给出效应的 5 %。按构造,它里面没有行间联系,每一行 都从一张白纸开始。Naibbe 密码也承载不了(z -1.6)。这是冗长模型这一类别的缺陷,不是我们实现的缺陷。 我们在测量当天就把它写进了第一篇论文的局限。
循环 d → q → y
十月,图景里加进了方向。如果一行以 d 开头,下一行更常以 q 开头;q 之后是 y;y 之后又是 d。 沿循环“向前”走的步子占 0.629,零模型为 0.498,z +5.8,在两份转写上都是如此;手稿的两只主要的手分别为 z +3.8 和 +3.7。
循环是有方向的,这正是它的价值。对重复的回避,任何一种习惯都能产生。方向则要求抄写者记住的不只是 “别像上一行”,还有“这样之后是那样”。
重新排版的检验
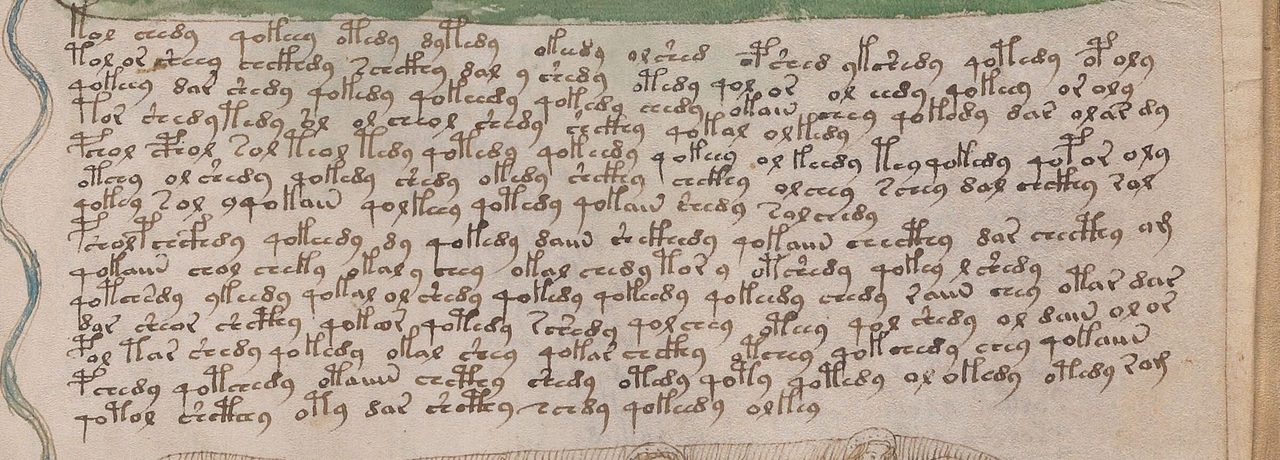
Jorge Stolfi,手稿最资深的研究者之一,提出了一项我们立刻采纳的对照:假如行只是对连续文本流的切分, 所有“行间”效应都只是换行恰好落在哪里的伪影呢?检验:移动换行位置重新排版文本,再测一次。对照的检验力 我们事先展示过。
重新排版把循环完全杀死:z 从 6.0 跌到 -0.7。回避的表现一样。可见效应属于作为书写单位的行,而不是 文本流。抄写者看着行,想着行。
没有一个
最有意思的是跑一遍目录。我们有十六个他人的生成器,Timm 和 Schinner 的自复制、带周期和不带周期的 Cardan 格栅、volvelle 转盘、模板、两级方案、按字符和按词的马尔可夫链、带记忆的架构、Sachek 的生成器, 还有我们自己的标准模型。
循环 d → q → y,目录里的十五个机制没有一个能承载。我们的标准模型:10 个种子中 9 个给出的 |z| 小于 2。 回避的量,自复制能拿到(目标的 83 %),靠的是纵向复制,不是位置;带周期的格栅则飞过头 8.6 倍。但有 方向的循环,没有一个。
我们试过修补标准模型:加一张行首偏好表。随机的表给不出循环(z 不超过 +1.3)。十张置换过的表里有一张 给出了 z +3.63,我们都准备高兴了,直到算出十次置换的平均值:-0.5。那是置换的运气,不是机制。强烈的 行首习惯给出的是符号随机的循环;手稿的循环要求的是它特定的方向。候选没有,我们也不去凑一个。
这意味着什么
措辞是谨慎的,我们盯着它。这不是“第三层意义”,那个我们在九月就撤回了,当时发现其他词间效应能由一条 简单的链复现。这是对解释类别的约束:任何自称是手稿的生成器,必须给出带偏好的行首回避和有方向的循环 d → q → y,而且二者在重新排版后消失。检验过的十六个里,没有一个做到。
这样的量我们有两个:这一个,以及沿 Morgallet 轴的行内形式位置选择。两者都关乎作为书写单位的行。两者 都在等待机制。
一个可信度中等的解读:抄写者的纵向纪律,与一行首词效应同族。不是明文的性质,切成行的拉丁文给不出 这个。若要算成功,需要找到一份那个时代的手稿,其中抄写者的行为相同;那时它就会成为某个书写流派的标志。
常见问题
什么是行首?
一行第一个词的第一个字形单位。手稿里早就知道,各行的第一个词构造不同:它们在 22 % 的情况下以“绞架字符”开头,而在行中是 8.5。我们问的是,相邻各行的行首是否彼此依赖。
如何验证这是真实行的性质,而不是文本流的性质?
用重新排版。如果手稿的行只是对连续文本流的任意切分,那么移动换行位置不应改变任何东西。它却把行首的循环完全杀死:z 从 6.0 跌到 -0.7。可见这个效应属于作为书写单位的行。
为什么这比又一个模型缺陷更重要?
因为普通的缺陷是我们自己的错误,别人的生成器可能没有。而这里,这个量在检验过的十五个机制中没有一个能承载,自复制不能,格栅不能,链不能,我们的标准模型也不能。任何未来的手稿模型都必须解释它。
这可能意味着什么?
一个可信度中等的解读:抄写者的纵向纪律,即不以上一行的开头方式开始新一行的习惯,与已知的首词效应同族。不是明文的性质。更深的解释我们没有。