已确立的结论
每个星座三十个名字:关于黄道带圆环中的标签,我们知道什么
黄道带各页宁芙旁边的题记,是手稿中最“可读”的部分:短小、独一无二、有自己的语法。我们知道它们不是数字,不是完整的名字,也不是随机的词。我们知道标签的词干在同一页上是共用的。我们不知道这些是谁的名字。
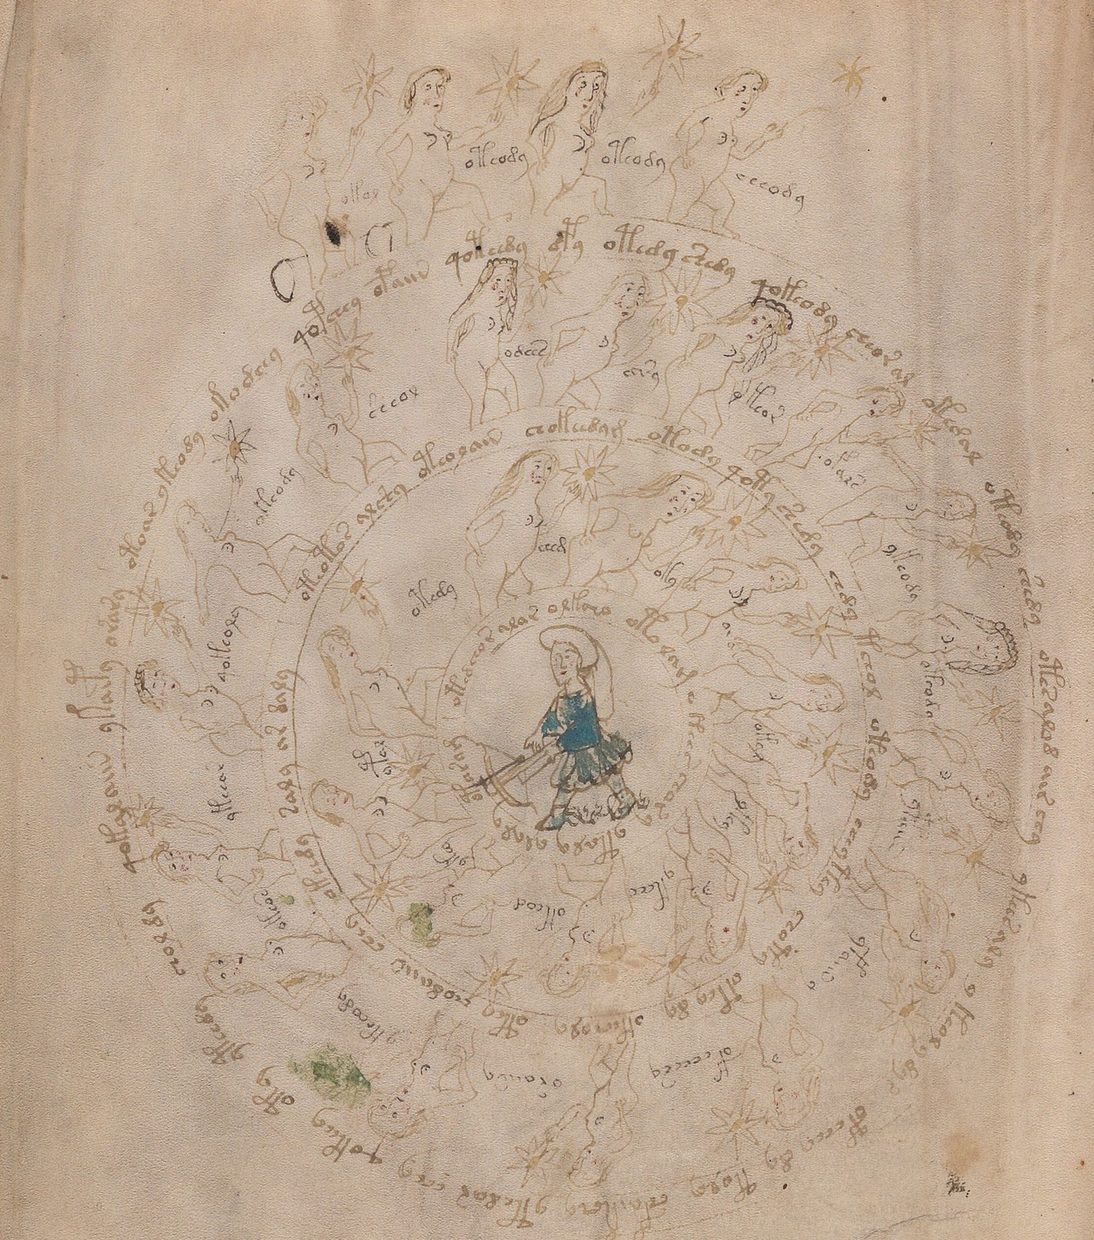
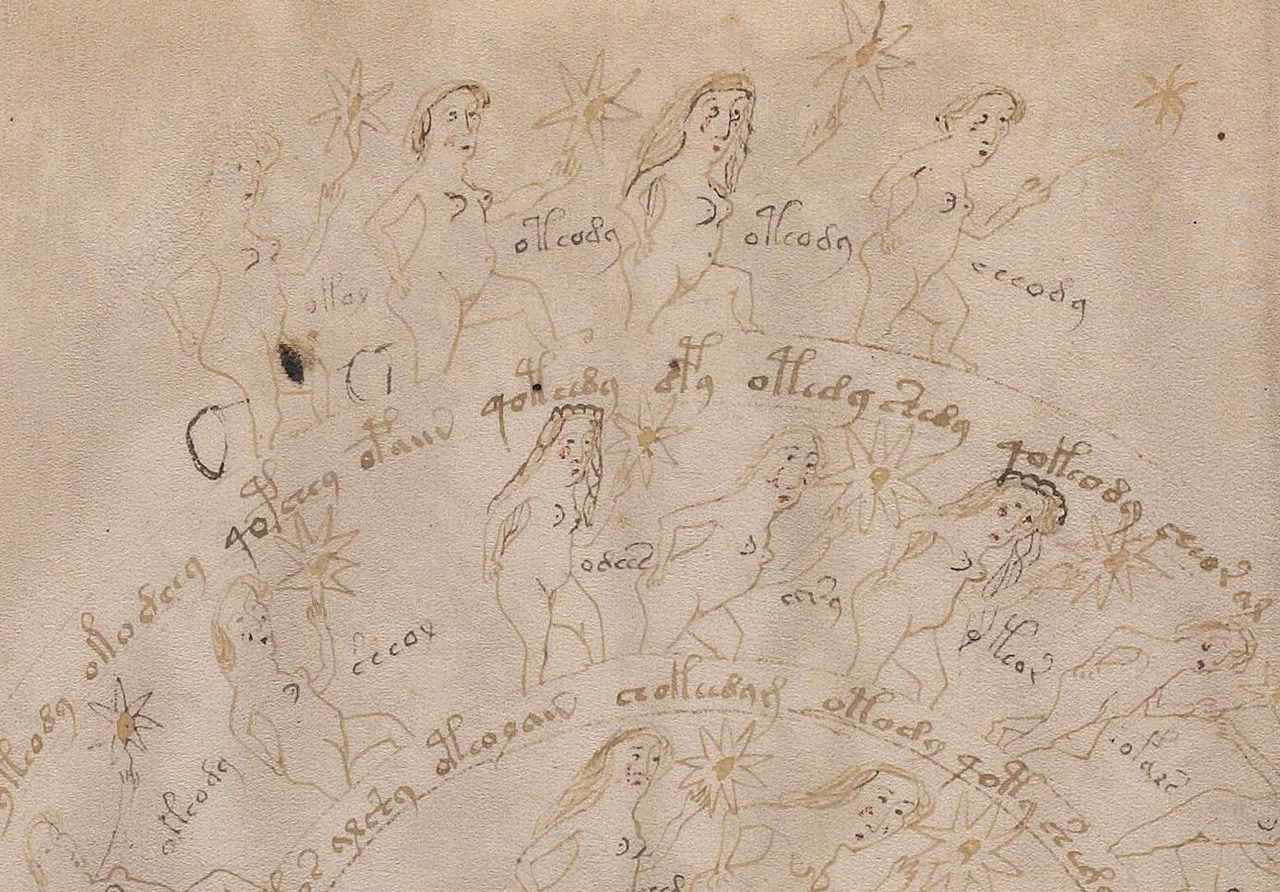
在手稿的黄道带各页上,每个星座周围站着宁芙,每一位手里一颗星,身旁一个短词。一百年来这些词引诱着 研究者:看哪,题记在这里,名字在这里。没有人读出过它们,包括我们。但在两年里,我们对它们了解到的比 对这本书任何其他部分都多,而这种了解是结构性的,不是词语性的。
它们有三十个,而且独一无二
从数字说起。在 f73r 和 f73v 两页上,题记恰好各三十条;按圆环平均,每个星座约三十个独一无二的题记。 三十度、三十天,这个巧合绕不过去。与此同时,题记几乎不重复,圆环之内不重复,圆环之间也不重复:其中 不同形式的占比是 0.77-0.80,而手稿普通文本是 0.20,两个圆环共有的标签实际上没有(相似度 0.005)。 每个星座有自己的名单。
第一个假说不请自来:这是编号。我们用四种方法检验,四次都没通过。最直观的一种:相邻的数字写法相似, 21、22、23 共用第一位数字。如果标签是数字,圆环上相邻的标签就会彼此相像。手稿的相邻性度量是 +0.8, 真正的数词约为 +7。标签不是在计数。
自成语法
标签不只是文本里的一个短词。它有自己的语法,我们用六个标记测量了它。这里零模型对照很重要:把标签与 文本直接比较并不公平,标签更短。所以“标签”或“文本”的标记是在“部分 × 词长”的分层内打乱的:90 个层, 10 000 次置换。留下来的是这些。
| 标记 | 标签中 | 文本中 | 倍数 |
|---|---|---|---|
词首 o- | 53.8 % | 20.6 % | 2.6 |
词首 qo- | 0.9 % | 15.2 % | 17(更少) |
重叠音节(olol、arar) | 3.05 % | 0.57 % | 5.3 |
词尾 -n | 7.5 % | 16.5 % | 2.2(更少) |
| 重叠字母 | 16.1 % | 24.9 % | 更少 |
罕见符号 x、v、g、b | 1.92 % | 0.44 % | 4.4 |
六项全部在 0.001 水平上显著。一个有趣的对照:标签喜欢重叠的音节,却回避重叠的字母。文本中最常见的 前缀 qo- 在标签里几乎被禁止,这是语域的切换,就好比名单里的名字不带冠词。
它们是缩写符号
多长的名字能塞进一个标签?按 Naibbe 类密码表,文本的词落在单字母的加密上(期望长度 4.43 个符号, 观测 4.45),而标签落在双字母的加密上(5.15 对 5.37)。344 个黄道带标签里没有一个需要三个字母。完整的 名字放不下。放得下的是缩写符号,即缩到两个字母的缩写,中世纪名单的通常做法。
接下来是最让我们信服的那项检验。如果标签是两个独立加密的字母,那么同一圆环内的标签对应当时不时恰好 共享两部分之一(共同的第一个字母或共同的第二个字母),而且比随机更频繁。事实正是如此:两个方向上 p 都小于 0.001。而药用部分的标签,即独一无二的植物名称,不给出这样的签名。可见这不是形式的普遍漂移, 而是黄道带标签本身的构造。
后来我们作了细化:标签不需要密钥里有自己的一节。不在表的词汇之内的标签形式,在 78.6 % 的情况下可 拆解为“密钥的一个词加上连写的另一个单元格”,伪词则是 58.5 %,这与文本中不寻常的形式一模一样。标签是 来自同一把密钥的两三个代码单位。
独立的见证
在一项一切都依赖于对一份转写文件的解析的研究里,需要外部对照。它找到了:Keito Yoshida 的数据集, 依据同一份文件、用另一套代码整理并公开发表。我们把它与我们的解析作了核对:883 个位点中的 883 个, 1021 个词次中的 1021 个,747 个类型中的 747 个,零分歧,十个位点类别全部吻合。标签清单得到了独立的 见证。
内容在哪里
还有一个维度把标签区别开来。拿手稿段落的正文和我们的生成器比较,两者几乎无法区分:行间相似度 0.068 对 0.090,词汇占比 0.198 对 0.107,熵 2.18 对 2.10。标签则在所有轴上都远离生成器:0.006、 0.728、2.53。手稿的散文在统计上像一道序列化程序;这本书里有区分力的东西,在标签里。
词干在同一页上共用
时间上最近的一项发现是 2026 年十月。我们问:标签的词干(它开头的几个符号)是圆环的性质,还是页的 性质?如果标签是名字的名单,词干应当落在页上;如果这是抄写者的方言,它也应当落在同一页的文本里。 标签的词干按页集中的程度强于同一些页上文本的词:z +8.05,而文本的第 97.5 百分位是 3.52;同一个月的 两页给出不同的词干(p 0.005)。标签的构造像一本命名簿,即每页有共同开头的名单。检验力 1.0,p 0.0004。
下一步,即把标签的尾部作为页内的区分项,撞上了体量:十二页上 244 个长于五个符号的标签给不出检验力 (0.29,阈值 0.8)。这个问题在现有标签上无法解决。
为什么标签读不出来
标签是手稿最好的锚点,正因如此我们在它们身上花费最多:十八类每个星座三十个的外部名单,从 cisiojanus 到 1488 年 Astrolabium 的度数图像和圣徒历。有一份名单,Lleida 历法,连过三道关卡,然后 被证明是伪影。其余全部为零。
再往下是算术:即便我们找到了正确的名单,三十个双字母缩写符号也只是六十个字母。要复原六张表的密钥, 需要多出两个数量级。详见文章《锚点阈值》。
说明:以上全部是标签的形式及其分布的性质,而不是释读。若要算成功,需要一份同一传统的外部手稿,带有 每个星座三十个名字的名单,并且每页有共同的词干。
常见问题
为什么标签不可能是从 1 到 30 的数字?
如果标签编码的是度数的编号,相邻的标签就会彼此相似,就像相邻数字的写法彼此相似一样。它们并不相似:手稿的相邻性统计量是 0.8,而真正的数词是 7。各圆环之间几乎不共享标签。用四种独立的方法检验过。
什么是缩写符号(siglum)?
把名字缩短到一两个字母,这是中世纪名单和历法里的通行做法。按密码表计算,标签的容量恰好是两个字母:完整的名字在物理上放不下。
凭什么确信标签清单解析正确?
Keito Yoshida 的独立数据集,依据同一份转写文件、用另一套代码整理,与我们的解析吻合到最后一个符号:883 个位点中的 883 个,1021 个词次中的 1021 个,零分歧。
能不能凭标签配出密钥?
这正是项目最主要的希望:一份每个星座三十个名字的外部名单。十八类这样的名单已经检验并否定,包括 1488 年 Astrolabium 的度数图像和圣徒历。标签本身太短,不足以充当锚点。