已确立的结论
六张表与五位抄写者:伏尼契手稿的文本是怎样构成的
我们没有读出一个词,但知道这段文本是怎样做出来的。这是一个故事:从一处反常,即文本过于可预测,长出了一个能同时复现手稿十项统计量的模型,以及它仍然出错的二十个地方。
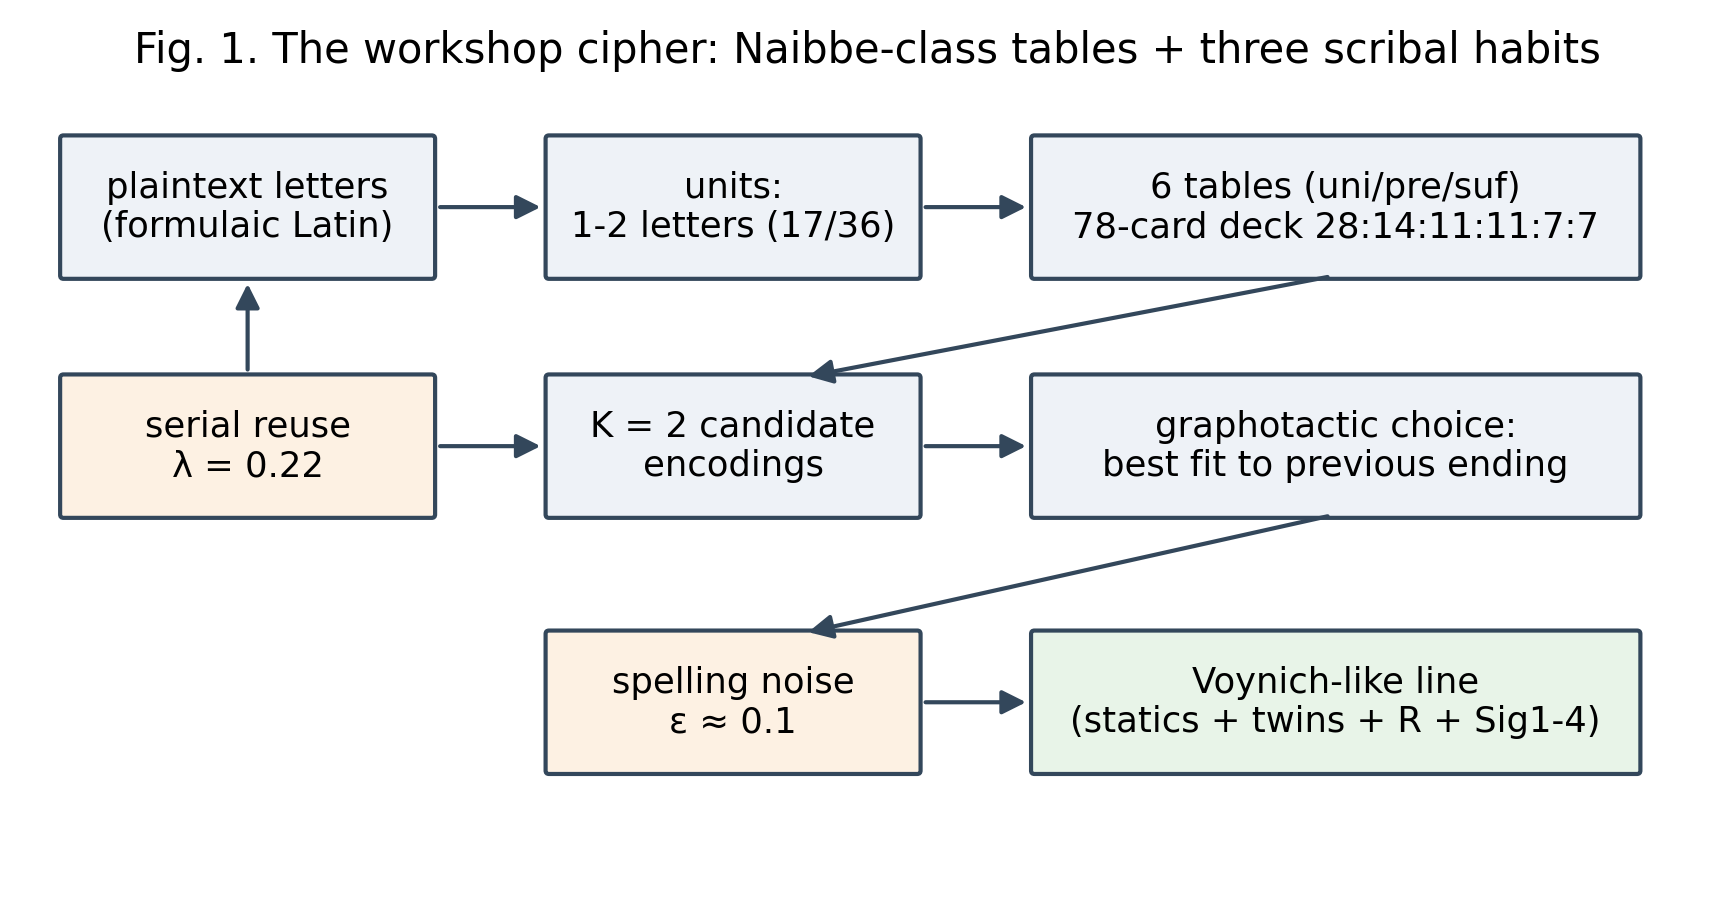
想象一位抄写者,面前摊着六张表。每张表里都是拉丁字母表,每个字母对面站着一组陌生的符号:一组用于 词首的字母,另一组用于词中,第三组用于词尾。抄写者取来源文本的一个音节,朝今天在用的三张表之一瞥 一眼,在羊皮纸上写下一个“词”。然后是下一个音节、下一个“词”。他有点偷懒:如果合适的一组就在眼前, 在这一行的前一个词里,他会更乐意再用一次。如果前一个词以某个特定符号结尾,他会挑一个能与之漂亮衔接 的变体。有时他会把一个“词”掰成两个,在两半本身都像词的地方。
这不是依据文件做的重建,文件并不存在。这是我们将近一年里一层一层搭起来的模型,每一层都只按预先宣布 的判据接受。下面讲它是怎么搭起来的,以及它会什么。
一切的起点:一处反常
伏尼契手稿的文本表现得像一种语言:它有 Zipf 定律,有“元音”和“辅音”的交替,各部分有自己的主题词汇。 同时它又不像语言:它的条件熵,也就是根据前一个符号预测下一个符号的可预测性,是 2.08-2.30 比特。 拉丁语、英语、芬兰语、德语和另外二十来种语言是 2.96 到 3.23。在词汇如此丰富的情况下,这么低的值在 任何自然语言的常规正字法里都不存在。我们把这叫作空角,坐在里面的只有 手稿。
简单替换密码不改变熵:我们让拉丁语经过“一个字母换一个符号”的替换,3.22 原来怎样还是怎样。而“一个 字母换两个符号”的替换把它压到 2.11。这就是支持冗长密码的第一个论据:在简单机制里,只有它能复现文本 最主要的古怪之处。
类别被独立地找到了两次
2026 年七月,我们把用 Naibbe 系统加密的文本放进自己的度量:那是 Michael Greshko 用纸牌和骰子构造、 并发表在 Cryptologia 上的一种历史上可信的密码。六张表、音节替换、同音替代。他的普林尼密文给出了 2.08 的低熵、正确的词长、正确的词缀占比,而且,最要紧的是,给出了我们最锋利的特征:80 % 的词服务于 大约六十个“核”。手稿有 55 个这样的核,作为来源的拉丁语有 641 个。
两条独立的路径汇合到同一类机制上。接下来是我们自己的工作:类别还不是模型。
模型的层,以及每一层关闭了什么
每一层加进来都只有一个理由:前一个版本没有复现手稿某项测得的统计量。每一层也都按同一条规则接受: 先前的指标全部完好,目标指标改善,没有一项恶化。
六张表。 静态指标:词长、熵、词汇占比。少于六张,双生词太少;一偏斜,全盘皆坏。
双生词与重用。 手稿里有 42 对写法形式不同、上下文却相同的词,比如 ol 和 chey、daiin 和 chol。这类词对的图恰好沿“语言”A 和 B 分裂成两个连通分量。双生词在一行之内的聚集度比随机强 1.87 倍。 这是序列性:抄写者以大约 0.22 的概率重用这一行的单位。
分段方言。 手稿的词是成簇的:某些形式在一段文本里密集出现,然后被替换掉。如果抄写者在大约 220 行的区段内,也就是一帖的中位长度内,用六张表中的三张工作,这一点就能复现。副产品是 Taylor 指数 0.650,目标是 0.678,以及“两种语言”之争的终结:A 和 B 是同一系统的两套词汇。
连音,即词的接缝。 在手稿里,一个词的结尾与下一个词的开头之间有 0.165 比特的信息。同音替代给 不出这一点,重用也给不出。能给出的是:按与前一个词的接缝,从三种拼写变体中选择。接缝偏好从语言 A 延续到语言 B(相关 0.75),这是抄写者的习惯,而不是明文的性质。
邻词的启动效应。 抄写者更乐意取与前一个词首符号相同(权重 1.75)、长度相近(1.35)的变体。这一层 一次关闭了四条轴。
软空格。 由两个单元格组成的词,如果两半都像词,就以 0.35 的概率分开写。 连写与分写的交替就是这样关闭的。
是技术,不是笔迹
支持“作坊”而非单个加密者的最强论据,来自五种笔迹的检验。古文书学家 Lisa Fagin Davis 在手稿中分辨出 五位抄写者。如果每个人各按自己的方式编码,不同笔迹的拼写变体会彼此分歧。它们却是汇合的:笔迹之间的 分歧 0.050,对照为 0.163,p 小于 0.001。五位抄写者全都以同样的比例使用这些变体。表是共用的。详见文章 《五位抄写者,一把钥匙》。
模型复现了什么
十项统计量同时成立:熵 2.17,词汇占比 0.30,双生词占比 1.2 %,其聚集度 1.87,接缝处的信息增益 0.165,y → q 上升 1.77 倍,词汇集中度,重复占比 0.94 %,聚集度 1.75,以及 Parisel 的全部四个“签名”, 也就是这位法国研究者提出作为真实文本判据的边界统计量。四项中的四项,没有调参。
还有来自另一边的对照:十六个他人的生成器,Timm 的自复制、格栅、volvelle 转盘、马尔可夫链、两级方案、 Lanzini 的无语义生成器、新近的带记忆架构,没有一个能通过我们的轮廓。几乎所有的都裂在同一处:双生词 的聚集度。
模型在哪里出错
诚实的清单比胜利的清单更重要。模型有二十个开放缺陷,即它承载不了的手稿测得统计量。主要的一族是 词汇:在模型的词汇已耗尽之处,手稿继续产生新形式。这个极限定位得很精确:组装规则“词是一个单元格, 或者前缀加后缀”覆盖了 77.7 % 的词次,却只覆盖 36.4 % 的不同形式。类别之内的修补能堵上一半的缺口; 再往下就需要更换规则。
有两个缺陷格外有意思,因为十六个机制里也没有一个能承载它们:行首和 行内形式的位置选择。这已经不是我们的错误,而是对任何一类解释的约束。带数字的完整表格在 《模型缺陷》页面。
为什么这不是破译
模型说的是文本“怎样”做成,而不是其中写了“什么”。我们检验过能否从模型推出密钥:限定为六张表的 求解器以 0.95 的准确率破解同一构造的合成文本,而在手稿上、在阈值 0.5 下只给出 0.04-0.07 的增益, 无论是拉丁语、亚美尼亚语、科普特语、古法语、加泰罗尼亚语、意大利语、奥克语、西班牙语还是中古高地 德语。因此,手稿并不是“我们的标准模型分毫不差,再加一种已知语言”。要么语言是另一种,要么密钥在 求解器敏感的细节上构造不同,而它甚至对抄写者在表中的一个错误都敏感。这对阅读的机会意味着什么,见 文章《锚点阈值》。
说明:以上所说的一切都是经统计量检验的机制模型,而不是释读。若要算成功,需要找到那些表本身或者 来源文本;那时模型在几小时内就会变成阅读的工具。
常见问题
什么是冗长密码?
一种密码,其中源文本的一个单位,一个字母或一个音节,被替换成若干个符号。文本因此变长,而下一个符号的可预测性上升,这正是我们在手稿中看到的。
怎么知道表恰好是六张?
靠穷举。少于六张,模型给不出所需数量的双生词;表的使用一旦偏斜,其余所有指标都会变坏。六张均衡的表,是十项统计量同时汇合的唯一一点。Michael Greshko 在 2025 年于 Cryptologia 杂志上独立地得出了同一类别。
那么,靠拟合这些表就能破译文本?
不能。我们直接检验过:一个能以 0.95 的准确率破解同一构造的合成文本的求解器,在手稿上、在十种语言之下保持沉默。要么源语言不在检验过的之列,要么密钥的构造在求解器敏感的细节上与我们的模型不同。
模型还有什么不好?
它有二十个经测量的缺陷,即手稿中它无法复现的统计量。主要的一族是词汇:在模型的词汇已经耗尽的地方,手稿继续产生新的形式。带数字的完整清单在“模型缺陷”页面。