Was feststeht
Sechs Tabellen und fünf Schreiber: wie der Text des Voynich-Manuskripts gebaut ist
Wir haben kein Wort gelesen, aber wir wissen, wie dieser Text gemacht wurde. Die Geschichte, wie aus einer einzigen Anomalie - einem zu vorhersagbaren Text - ein Modell wuchs, das zehn Statistiken der Handschrift auf einmal reproduziert, und von den zwanzig Stellen, an denen es noch immer irrt.
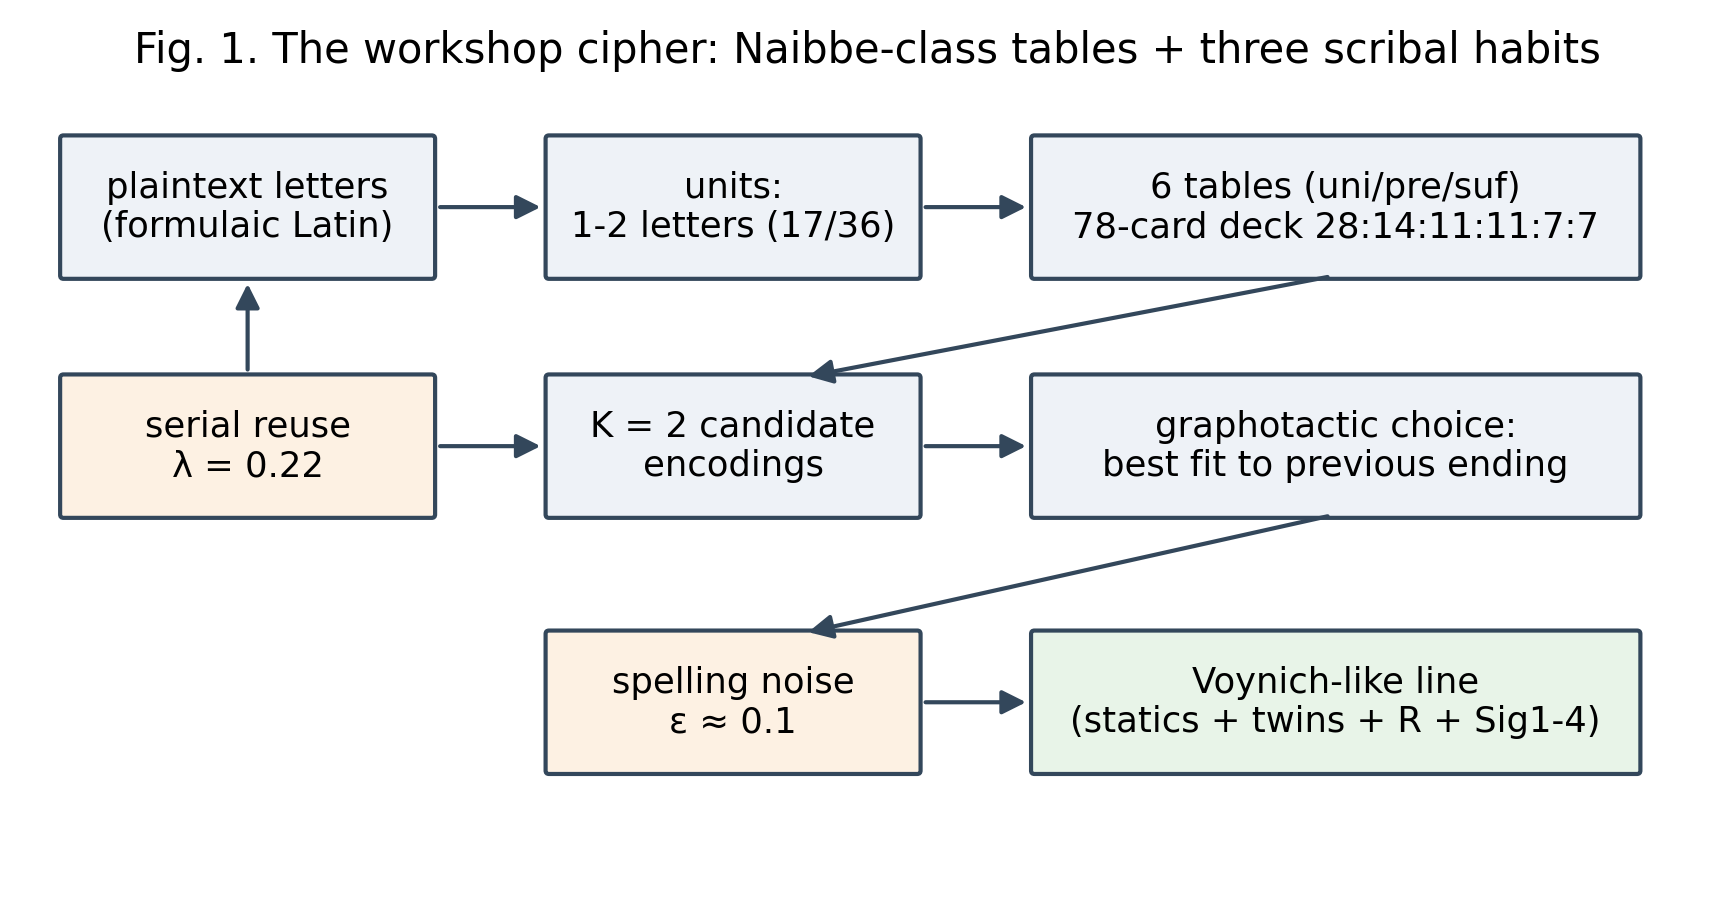
Stellen Sie sich einen Schreiber vor, vor dem sechs Tabellen liegen. In jeder steht das lateinische Alphabet, und neben jedem Buchstaben eine Gruppe fremder Zeichen: eine für den Buchstaben am Wortanfang, eine für die Mitte, eine dritte für das Ende. Der Schreiber nimmt eine Silbe des Ausgangstextes, wirft einen Blick in eine der drei Tabellen, mit denen er heute arbeitet, und setzt ein „Wort“ aufs Pergament. Dann die nächste Silbe, das nächste „Wort“. Er ist ein wenig faul: Steht eine passende Gruppe gerade vor seinen Augen - im vorigen Wort der Zeile -, nimmt er sie lieber noch einmal. Endete das letzte Wort auf ein bestimmtes Zeichen, wählt er die Variante, die sich hübsch daran anschließt. Manchmal zerreißt er ein „Wort“ in zwei, wo beide Hälften selbst wie Wörter aussehen.
Das ist keine Rekonstruktion nach einem Dokument - ein Dokument gibt es nicht. Es ist ein Modell, das wir fast ein Jahr lang Schicht für Schicht zusammengesetzt haben, und jede Schicht wurde nur nach einem vorher angekündigten Kriterium angenommen. Unten steht, wie es zusammengesetzt wurde und was es kann.
Die Anomalie, mit der alles begann
Der Text des Voynich-Manuskripts verhält sich wie eine Sprache - er folgt dem Zipfschen Gesetz, er wechselt „Vokale“ und „Konsonanten“, sein Wortschatz ist nach Abschnitten thematisch. Und zugleich nicht wie eine Sprache: Seine bedingte Entropie, also die Vorhersagbarkeit des nächsten Zeichens aus dem vorigen, liegt bei 2.08-2.30 Bit. Bei Latein, Englisch, Finnisch, Deutsch und zwei Dutzend weiteren Sprachen liegt sie zwischen 2.96 und 3.23. Einen so niedrigen Wert bei einem so reichen Wortschatz hat keine natürliche Sprache in ihrer gewöhnlichen Orthographie. Wir nennen das die leere Ecke, und darin sitzt nur die Handschrift.
Eine einfache Substitutionschiffre ändert die Entropie nicht: Wir haben Latein durch eine Ersetzung „Buchstabe zu Zeichen“ geschickt - 3.22, wie vorher, so nachher. Eine Ersetzung „Buchstabe zu zwei Zeichen“ dagegen drückt sie auf 2.11. Das ist das erste Argument für eine verbose Chiffre: Von allen einfachen Mechanismen ist sie der einzige, der die zentrale Merkwürdigkeit des Textes reproduziert.
Die Klasse wurde zweimal unabhängig gefunden
Im Juli 2026 haben wir einen Text durch unsere Metriken geschickt, der mit dem System Naibbe verschlüsselt war - einer historisch plausiblen Chiffre, die Michael Greshko aus Karten und Würfeln gebaut und in Cryptologia veröffentlicht hat. Sechs Tabellen, silbische Ersetzung, Homophone. Sein Chiffretext des Plinius ergab die niedrige Entropie 2.08, die richtige Wortlänge, den richtigen Anteil an Affixen und - vor allem - unser schärfstes Merkmal: 80 % der Wörter bedienen rund sechzig „Kerne“. Die Handschrift hat 55 solcher Kerne, das lateinische Original 641.
Zwei unabhängige Ansätze liefen auf eine Klasse von Mechanismen zusammen. Dann kam unsere Arbeit: Eine Klasse ist noch kein Modell.
Die Schichten des Modells und was jede schließt
Jede Schicht wurde aus einem einzigen Grund hinzugefügt: Die vorige Version reproduzierte irgendeine gemessene Statistik der Handschrift nicht. Und jede wurde nach einer Regel angenommen: alle früheren Kennwerte unversehrt, der Zielwert verbessert, keiner verschlechtert.
Sechs Tabellen. Die Statik: Wortlänge, Entropie, Wortschatzanteil. Weniger als sechs - zu wenige Dubletten; eine Schieflage - verdirbt alles.
Dubletten und Wiederverwendung. Die Handschrift hat 42 Wortpaare mit formal verschiedener Schreibung und identischen Kontexten - ol und chey, daiin und chol. Der Graph dieser Paare zerfällt in genau zwei Komponenten entlang der „Sprachen“ A und B. Dubletten klumpen sich in der Zeile 1.87-mal stärker als der Zufall. Das ist Serialität: Der Schreiber verwendet die Einheiten einer Zeile mit einer Wahrscheinlichkeit von etwa 0.22 wieder.
Abschnittsdialekt. Die Wörter der Handschrift treten in Klumpen auf: Bestimmte Formen laufen dicht über einen Abschnitt des Textes und werden dann abgelöst. Das wird reproduziert, wenn der Schreiber über einen Abschnitt von rund 220 Zeilen - dem Median einer Lage - mit drei der sechs Tabellen arbeitet. Eine Nebenwirkung ist der Taylor-Exponent 0.650 bei einem Ziel von 0.678 und das Ende des Streits um die „zwei Sprachen“: A und B sind zwei Lexika eines Systems.
Sandhi - die Wortfuge. Zwischen dem Ende eines Wortes und dem Anfang des nächsten trägt die Handschrift 0.165 Bit Information. Homophonie gibt das nicht, Wiederverwendung auch nicht. Was es gibt, ist die Wahl unter drei Schreibvarianten nach der Fuge zum vorigen Wort. Die Vorlieben an der Fuge übertragen sich von Sprache A auf Sprache B (Korrelation 0.75) - ein Schreibergebrauch, keine Eigenschaft des Klartexts.
Priming durch den Nachbarn. Der Schreiber nimmt lieber eine Variante mit demselben ersten Zeichen wie das vorige Wort (Gewicht 1.75) und von ähnlicher Länge (1.35). Diese Schicht hat vier Achsen auf einmal geschlossen.
Weicher Wortzwischenraum. Ein Wort aus zwei Zellen wird mit einer Wahrscheinlichkeit von 0.35 getrennt geschrieben, wenn beide Hälften wie Wörter aussehen. So wurde der Wechsel von Zusammen- und Getrenntschreibung geschlossen.
Eine Technologie, keine Handschrift
Das stärkste Argument für eine „Werkstatt“ statt für einen einzelnen Verschlüssler lieferte der Test über fünf Hände. Die Paläographin Lisa Fagin Davis unterscheidet in der Handschrift fünf Schreiber. Hätte jeder auf seine Weise kodiert, würden die Schreibvarianten der verschiedenen Hände auseinanderlaufen. Sie laufen zusammen: Die Abweichung zwischen den Händen beträgt 0.050 gegen 0.163 bei den Kontrollen, p unter 0.001. Alle fünf Schreiber nutzen die Varianten in denselben Proportionen. Die Tabellen waren gemeinsam. Mehr dazu im Artikel Fünf Schreiber, ein Schlüssel.
Was das Modell reproduziert
Zehn Statistiken zugleich: Entropie 2.17, Wortschatzanteil 0.30, Anteil der Dubletten 1.2 %, ihre Klumpung 1.87, Informationsgewinn an der Fuge 0.165, Anstieg von y → q um das 1.77-fache, Konzentration des Wortschatzes, Anteil der Wiederholungen 0.94 %, Klumpung 1.75 und alle vier „Signaturen“ Parisels - die Grenzstatistiken, die der französische Forscher als Kriterium für echten Text vorgeschlagen hat. Vier von vier, ohne Anpassung.
Und die Kontrolle von der anderen Seite: sechzehn fremde Generatoren - Timms Selbstkopieren, Gitter, Volvellen, Markow-Ketten, zweistufige Schemata, Lanzinis asemischer Generator, neue Architekturen mit Gedächtnis - und durch unser Profil kommt kein einziger. Fast bei allen reißt es an derselben Stelle: der Klumpung der Dubletten.
Wo das Modell irrt
Eine ehrliche Liste ist wichtiger als eine triumphale. Das Modell hat zwanzig offene Defekte - gemessene Statistiken der Handschrift, die es nicht trägt. Die wichtigste Familie ist der Wortschatz: Die Handschrift bringt weiter neue Formen hervor, wo beim Modell der Wortschatz erschöpft ist. Die Grenze ist genau verortet: Die Zusammenbauregel „ein Wort ist eine Zelle oder ein Präfix plus ein Suffix“ deckt 77.7 % der Wortvorkommen ab, aber nur 36.4 % der verschiedenen Formen. Eine Reparatur innerhalb der Klasse schließt die Hälfte der Lücke; darüber hinaus muss die Regel selbst wechseln.
Zwei Defekte sind besonders interessant, weil keiner der sechzehn Mechanismen sie trägt - die Zeilenanfänge und die positionsabhängige Wahl der Form innerhalb der Zeile. Das ist nicht mehr unser Fehler, sondern eine Einschränkung für jede Klasse von Erklärungen. Die vollständige Tabelle mit Zahlen steht auf der Seite Defekte des Modells.
Warum das keine Entzifferung ist
Das Modell sagt, WIE der Text gemacht wurde, nicht WAS darin steht. Wir haben geprüft, ob sich aus dem Modell ein Schlüssel ableiten lässt: Ein Löser mit der Beschränkung auf sechs Tabellen knackt synthetischen Text desselben Baus mit einer Genauigkeit von 0.95 und liefert auf der Handschrift einen Zuwachs von 0.04-0.07 bei einer Schwelle von 0.5 - unter Latein, Armenisch, Koptisch, Altfranzösisch, Katalanisch, Italienisch, Okzitanisch, Spanisch und Mittelhochdeutsch. Die Handschrift ist also nicht „unser Kanon in exakter Form plus eine bekannte Sprache“. Entweder ist die Sprache eine andere, oder der Schlüssel ist in Einzelheiten anders gebaut, auf die der Löser empfindlich reagiert - und er reagiert schon auf einen einzigen Schreiberfehler in einer Tabelle. Was das für die Chancen einer Lesung bedeutet, steht im Artikel Ankerschwelle.
Zum Verständnis: Alles hier Gesagte ist ein Modell des Mechanismus, an Statistiken geprüft, keine Lesung. Ein Erfolg wäre der Fund der Tabellen selbst oder des Quelltextes; dann wird das Modell binnen Stunden zum Werkzeug des Lesens.
Häufige Fragen
Was ist eine verbose Chiffre?
Eine Chiffre, in der eine Einheit des Ausgangstextes - ein Buchstabe oder eine Silbe - durch mehrere Zeichen ersetzt wird. Der Text wird dadurch länger, und die Vorhersagbarkeit des nächsten Zeichens steigt - genau das, was wir bei der Handschrift sehen.
Woher weiß man, dass es genau sechs Tabellen sind?
Aus dem Durchprobieren. Mit weniger als sechs liefert das Modell nicht die nötige Zahl von Dubletten; eine Schieflage in der Nutzung der Tabellen verdirbt alle übrigen Kennwerte. Sechs ausgewogene Tabellen sind der einzige Punkt, an dem zehn Statistiken zugleich zusammenlaufen. Unabhängig davon kam Michael Greshko 2025 in der Zeitschrift Cryptologia zur selben Klasse.
Dann lässt sich der Text entziffern, indem man die Tabellen anpasst?
Nein. Wir haben das direkt geprüft - ein Löser, der synthetischen Text desselben Baus mit einer Genauigkeit von 0.95 knackt, schweigt auf der Handschrift unter zehn Sprachen. Entweder ist die Ausgangssprache nicht unter den geprüften, oder der Bau des Schlüssels weicht in Einzelheiten von unserem Modell ab, auf die der Löser empfindlich reagiert.
Was ist am Modell sonst noch schlecht?
Es hat zwanzig gemessene Defekte - Statistiken der Handschrift, die es nicht reproduziert. Die wichtigste Familie ist der Wortschatz: Die Handschrift bringt weiter neue Formen hervor, wo beim Modell der Wortschatz erschöpft ist. Die vollständige Liste mit Zahlen steht auf der Seite „Defekte des Modells“.