Che cosa è stabilito
Sei tavole e cinque scribi: com'è fatto il testo del manoscritto Voynich
Non abbiamo letto una parola, ma sappiamo come questo testo è stato fatto. La storia di come da una sola anomalia, un testo troppo prevedibile, è cresciuto un modello che riproduce dieci statistiche del manoscritto in un colpo solo, e dei venti punti in cui ancora sbaglia.
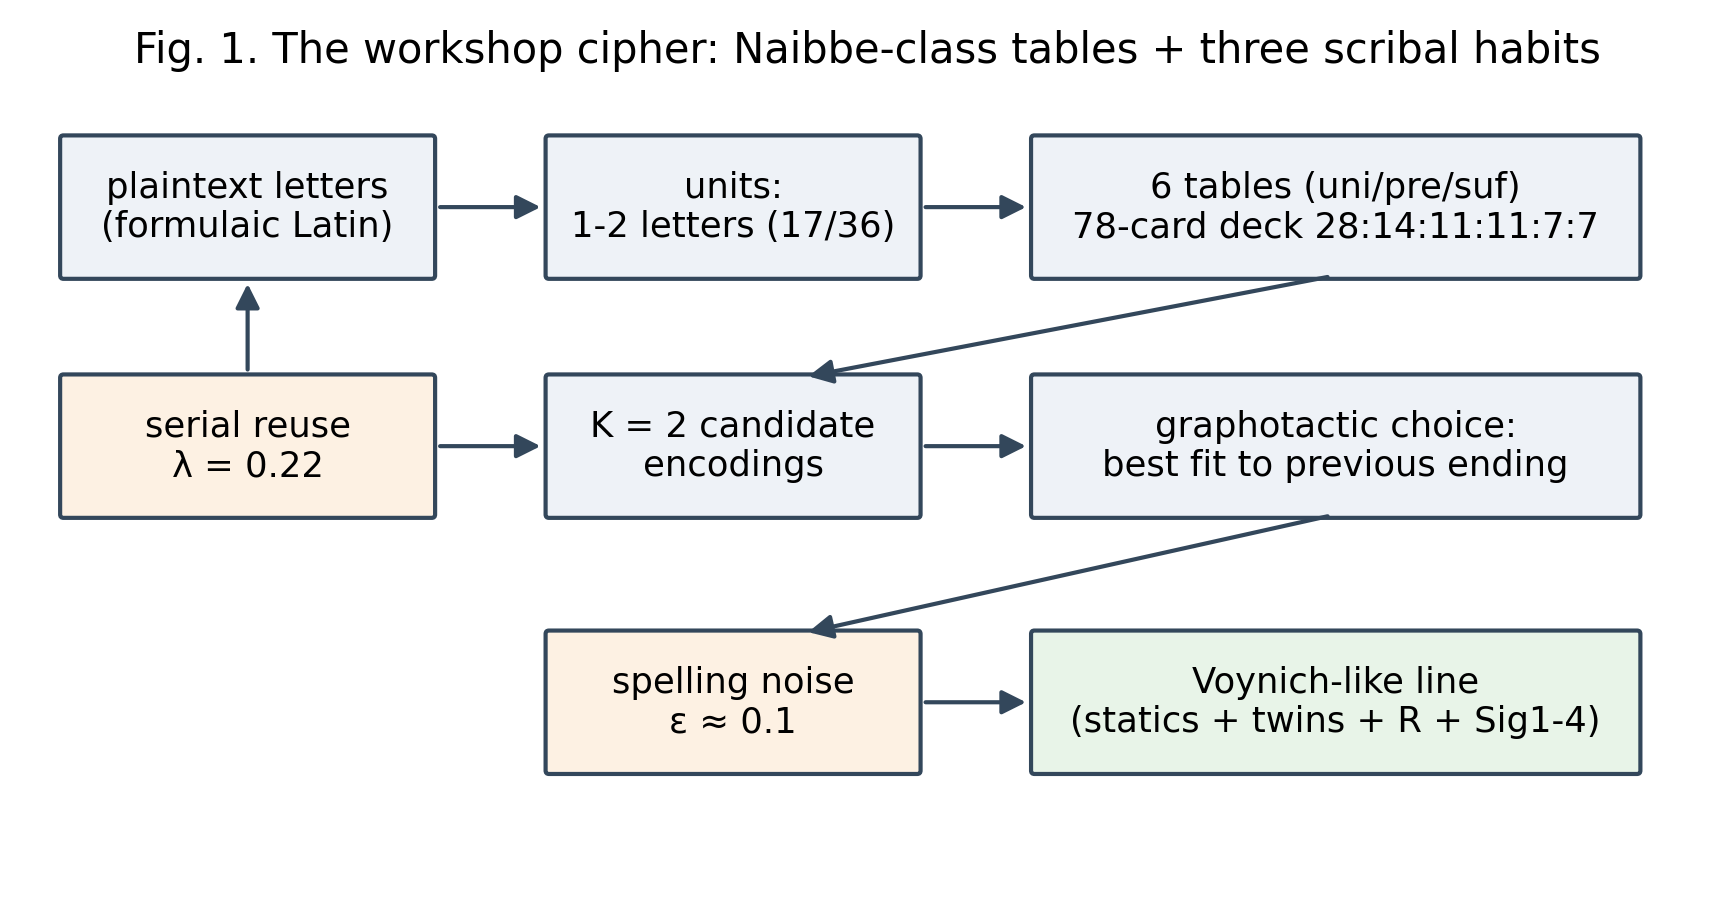
Immaginate uno scriba con davanti sei tavole. In ciascuna c'è l'alfabeto latino, e accanto a ogni lettera sta un gruppo di segni estranei: uno per la lettera a inizio di parola, un altro per il mezzo, un terzo per la fine. Lo scriba prende una sillaba del testo di partenza, getta lo sguardo su una delle tre tavole con cui lavora oggi e traccia sulla pergamena una «parola». Poi la sillaba successiva, la «parola» successiva. È un po' pigro: se il gruppo adatto gli sta davanti agli occhi, nella parola precedente della riga, lo riprenderà volentieri. Se la parola passata finiva con un certo segno, sceglierà la variante che vi si aggancia con grazia. Talvolta spezza una «parola» in due là dove entrambe le metà somigliano già a parole.
Non è una ricostruzione da un documento: il documento non c'è. È un modello che abbiamo assemblato strato dopo strato per quasi un anno, e ogni strato è stato accettato solo in base a un criterio dichiarato in anticipo. Qui sotto, come è stato assemblato e che cosa sa fare.
L'anomalia da cui tutto è cominciato
Il testo del manoscritto Voynich si comporta come una lingua: vi si trovano la legge di Zipf, l'alternanza di «vocali» e «consonanti», un lessico tematico per sezioni. E al tempo stesso non come una lingua: la sua entropia condizionale, cioè la prevedibilità del segno successivo dato il precedente, è di 2.08-2.30 bit. In latino, inglese, finlandese, tedesco e in altre due dozzine di lingue va da 2.96 a 3.23. Un valore così basso con un lessico così ricco non lo ha nessuna lingua naturale nella sua ortografia ordinaria. Lo chiamiamo angolo vuoto, e dentro vi siede soltanto il manoscritto.
Un cifrario a sostituzione semplice non cambia l'entropia: abbiamo passato il latino attraverso una sostituzione «lettera in segno», ed è rimasta a 3.22, com'era. Una sostituzione «lettera in due segni», invece, la fa precipitare a 2.11. È il primo argomento a favore del cifrario verboso: tra i meccanismi semplici è l'unico a riprodurre la stranezza principale del testo.
La classe è stata trovata due volte, indipendentemente
Nel luglio 2026 abbiamo passato attraverso le nostre metriche un testo cifrato con il sistema Naibbe, un cifrario storicamente plausibile che Michael Greshko ha costruito con carte e dadi e pubblicato su Cryptologia. Sei tavole, sostituzione sillabica, omofoni. Il suo testo cifrato di Plinio ha dato una bassa entropia, 2.08, la lunghezza di parola giusta, la quota giusta di affissi e, soprattutto, il nostro tratto più tagliente: l'80 % delle parole serve una sessantina di «nuclei». Il manoscritto di nuclei simili ne ha 55, il latino di partenza 641.
Due approcci indipendenti sono convenuti su una sola classe di meccanismi. Poi è venuto il nostro lavoro: una classe non è ancora un modello.
Gli strati del modello e che cosa chiude ciascuno
Ogni strato è stato aggiunto per una sola ragione: la versione precedente non riproduceva qualche statistica misurata del manoscritto. E ciascuno è stato accettato secondo una regola: tutti gli indicatori precedenti intatti, quello bersaglio migliorato, nessuno peggiorato.
Sei tavole. La statica: lunghezza di parola, entropia, quota del lessico. Meno di sei: pochi doppioni; uno squilibrio: guasta tutto.
Doppioni e riuso. Nel manoscritto ci sono 42 coppie di parole con grafia formalmente diversa e contesti identici: ol e chey, daiin e chol. Il grafo di queste coppie si spezza esattamente in due componenti lungo le «lingue» A e B. I doppioni si addensano nella riga 1.87 volte più del caso. È serialità: lo scriba riusa le unità della riga con probabilità intorno a 0.22.
Dialetto di sezione. Le parole del manoscritto vanno a grappoli: certe forme corrono fitte lungo un tratto di testo, poi si avvicendano. Questo si riproduce se lo scriba lavora con tre tavole su sei lungo un tratto di circa 220 righe, la mediana di un fascicolo. Effetto collaterale: un esponente di Taylor di 0.650 contro un bersaglio di 0.678 e la chiusura della disputa sulle «due lingue»: A e B sono due lessici di un unico sistema.
Sandhi, la giuntura tra parole. Tra la fine di una parola e l'inizio della successiva il manoscritto porta 0.165 bit di informazione. L'omofonia non li dà, il riuso nemmeno. Li dà la scelta fra tre varianti grafiche in base alla giuntura con la parola precedente. Le preferenze di giuntura passano dalla lingua A alla lingua B (correlazione 0.75): una consuetudine scrittoria, non una proprietà del testo in chiaro.
Priming dal vicino. Lo scriba prende più volentieri la variante con lo stesso primo segno della parola precedente (peso 1.75) e di lunghezza vicina (1.35). Questo strato ha chiuso quattro assi in un colpo.
Spazio morbido. Una parola di due celle si scrive staccata con probabilità 0.35, se entrambe le metà somigliano a parole. Così si è chiusa l'alternanza fra scrittura unita e staccata.
Una tecnologia, non una grafia
L'argomento più forte a favore della «bottega», e non di un singolo cifratore, lo ha dato il test sulle cinque mani. La paleografa Lisa Fagin Davis distingue nel manoscritto cinque scribi. Se ciascuno avesse codificato a modo suo, le varianti grafiche delle diverse mani divergerebbero. Convergono: la divergenza tra le mani è 0.050 contro 0.163 nei controlli, p sotto 0.001. Tutti e cinque gli scribi usano le varianti nelle stesse proporzioni. Le tavole erano comuni. Di più nell'articolo «Cinque scribi, una chiave».
Che cosa riproduce il modello
Dieci statistiche insieme: entropia 2.17, quota del lessico 0.30, quota dei doppioni 1.2 %, il loro addensamento 1.87, guadagno di informazione alla giuntura 0.165, la salita y → q di 1.77 volte, la concentrazione del lessico, la quota di ripetizioni 0.94 %, l'addensamento 1.75 e tutte e quattro le «firme» di Parisel, le statistiche di confine che il ricercatore francese ha proposto come criterio di testo autentico. Quattro su quattro, senza aggiustamenti.
E il controllo dall'altro lato: sedici generatori altrui, l'autocopiatura di Timm, le griglie, le volvelle, le catene di Markov, gli schemi a due stadi, il generatore asemico di Lanzini, le architetture recenti con memoria, e attraverso il nostro profilo non ne passa nessuno. Quasi tutti si strappano nello stesso punto: l'addensamento dei doppioni.
Dove il modello sbaglia
Un elenco onesto vale più di uno trionfale. Il modello ha venti difetti aperti: statistiche misurate del manoscritto che non porta. La famiglia principale è il lessico: il manoscritto continua a generare forme nuove là dove il lessico del modello è esaurito. Il limite è localizzato con precisione: la regola di assemblaggio «parola = una cella, oppure prefisso più desinenza» copre il 77.7 % delle occorrenze ma solo il 36.4 % delle forme distinte. Una riparazione dentro la classe chiude metà del divario; oltre serve cambiare la regola.
Due difetti sono particolarmente interessanti, perché non li porta nessuno dei sedici meccanismi: gli incipit delle righe e la scelta posizionale della forma dentro la riga. Non è più un nostro errore, ma un vincolo su qualunque classe di spiegazioni. La tabella completa con i numeri è nella pagina «Difetti del modello».
Perché questa non è una decifrazione
Il modello dice COME è fatto il testo, non CHE COSA vi è scritto. Abbiamo verificato se dal modello si possa ricavare la chiave: un risolutore vincolato a sei tavole forza un testo sintetico della stessa fattura con precisione 0.95, e sul manoscritto dà un guadagno di 0.04-0.07 con soglia 0.5, sotto latino, armeno, copto, francese antico, catalano, italiano, occitano, spagnolo e medio alto tedesco. Dunque il manoscritto non è «il nostro canone alla lettera più una lingua nota». O la lingua è un'altra, o la chiave è costruita diversamente in dettagli ai quali il risolutore è sensibile, ed è sensibile perfino a un solo errore dello scriba in una tavola. Che cosa questo significhi per le possibilità di lettura è nell'articolo «La soglia dell'ancora».
Per intendersi: tutto ciò che è stato detto è un modello del meccanismo, verificato sulle statistiche, non una lettura. Un successo sarebbe il ritrovamento delle tavole stesse o del testo di partenza; allora il modello diventerebbe uno strumento di lettura nel giro di ore.
Domande frequenti
Che cos'è un cifrario verboso?
Un cifrario in cui una sola unità del testo di partenza, una lettera o una sillaba, viene sostituita da più segni. Il testo si allunga, e la prevedibilità del segno successivo cresce: esattamente ciò che vediamo nel manoscritto.
Come si sa che le tavole sono proprio sei?
Per esaurimento delle alternative. Con meno di sei il modello non dà il numero necessario di parole doppione; uno squilibrio nell'uso delle tavole guasta tutti gli altri indicatori. Sei tavole bilanciate sono l'unico punto in cui dieci statistiche convergono insieme. Alla stessa classe è arrivato indipendentemente Michael Greshko sulla rivista Cryptologia nel 2025.
Dunque il testo si può decifrare indovinando le tavole?
No. Lo abbiamo verificato direttamente: un risolutore che forza un testo sintetico della stessa fattura con precisione 0.95 resta muto sul manoscritto sotto dieci lingue. O la lingua di partenza non è tra quelle provate, o la struttura della chiave differisce dal nostro modello in dettagli ai quali il risolutore è sensibile.
In che altro il modello è carente?
Ha venti difetti misurati: statistiche del manoscritto che non riproduce. La famiglia principale è il lessico: il manoscritto continua a generare forme nuove là dove il lessico del modello è esaurito. L'elenco completo con i numeri è nella pagina «Difetti del modello».