Was feststeht
Dreißig Namen je Zeichen: was wir über die Etiketten in den Tierkreisringen wissen
Die Beschriftungen neben den Nymphen auf den Tierkreisblättern sind der „lesbarste“ Teil der Handschrift - kurz, einmalig, mit eigener Grammatik. Wir wissen, dass es keine Zahlen, keine vollständigen Namen und keine zufälligen Wörter sind. Wir wissen, dass der Stamm eines Etiketts dem Blatt gemeinsam ist. Wir wissen nicht, wessen Namen es sind.
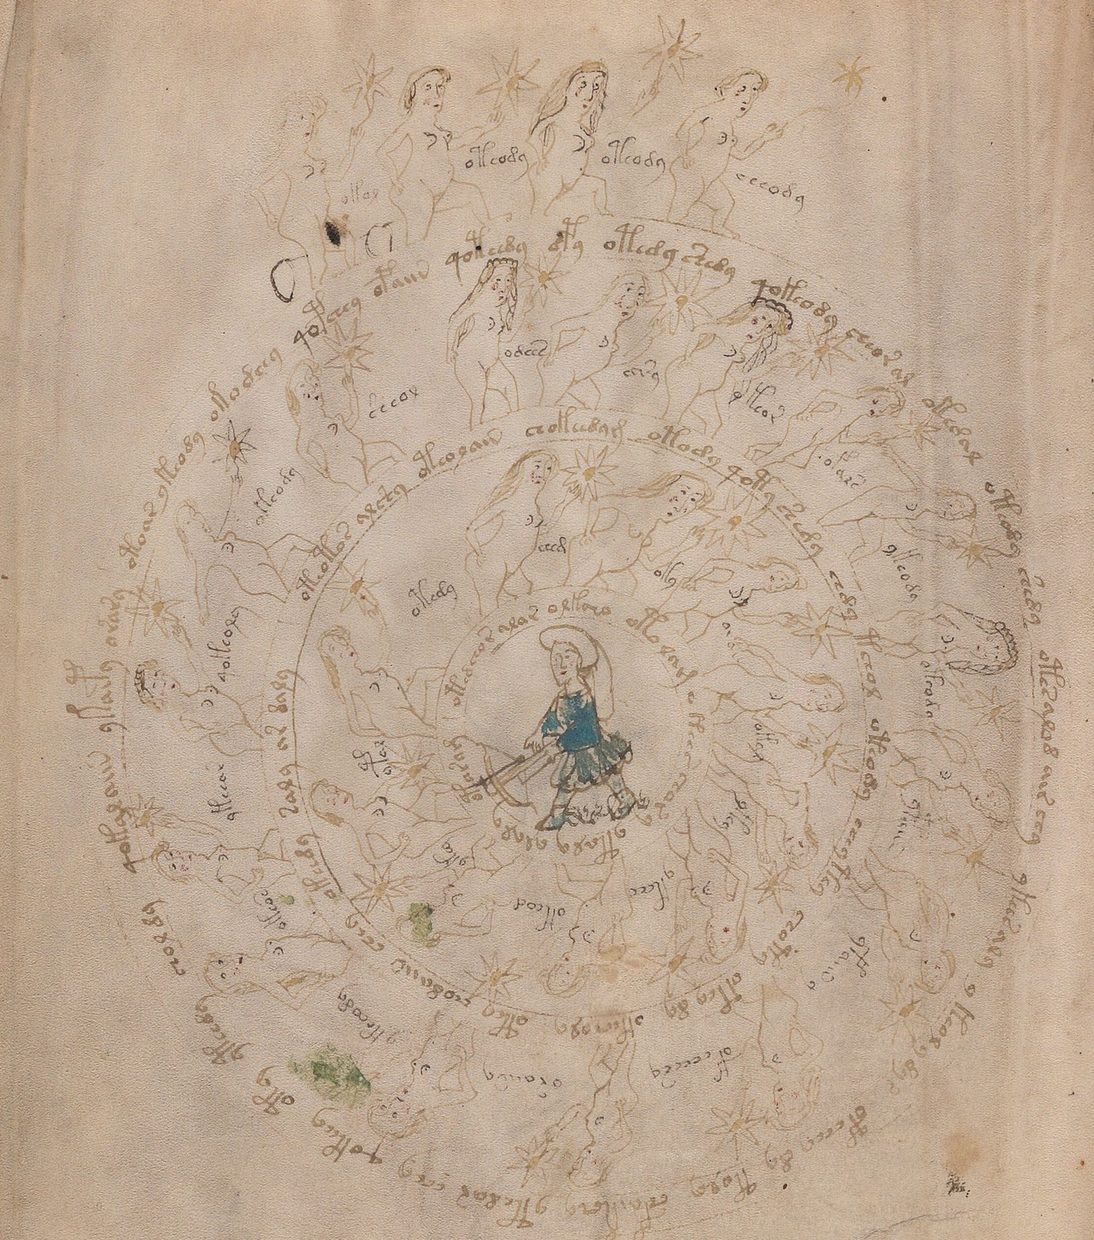
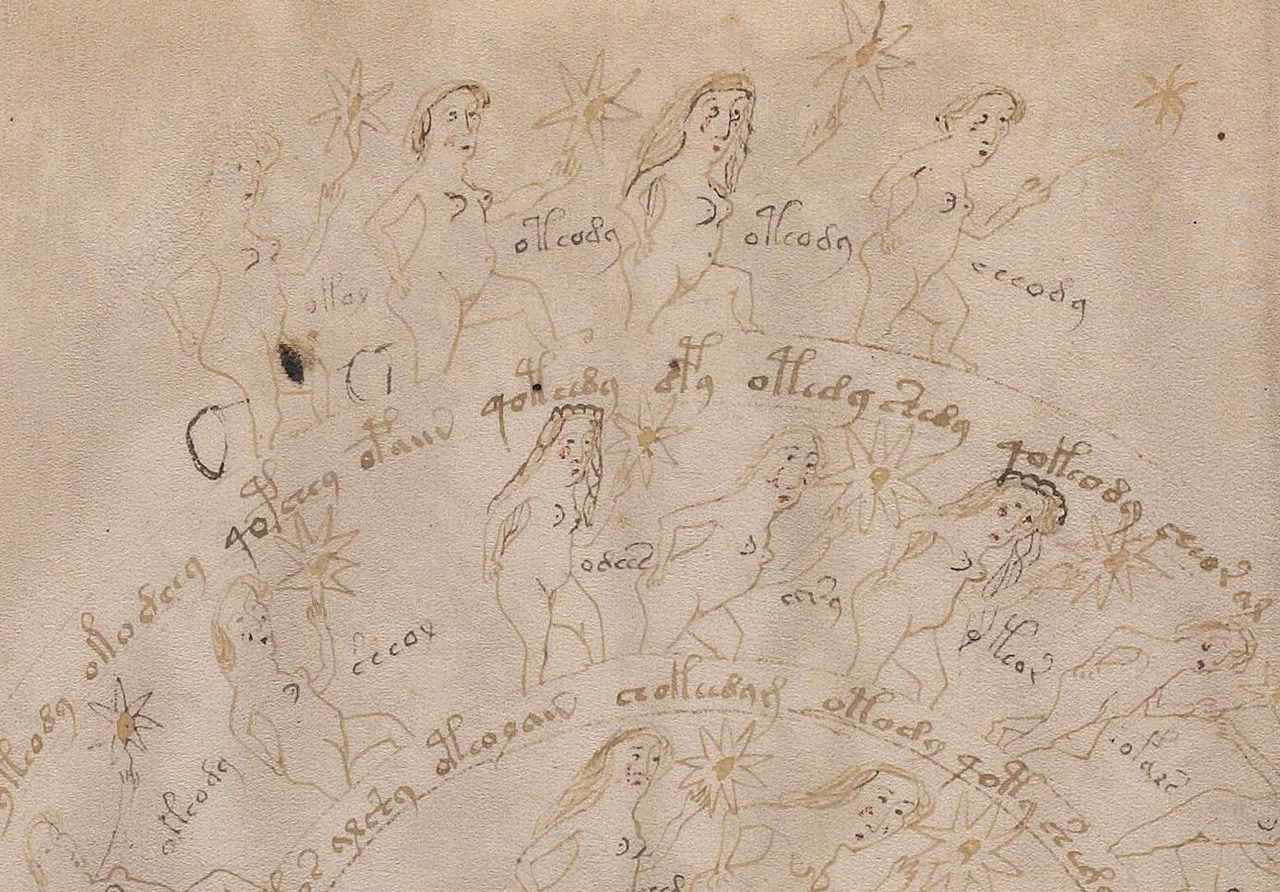
Auf den Tierkreisblättern der Handschrift stehen um jedes Zeichen Nymphen, jede mit einem Stern in der Hand und einem kurzen Wort daneben. Seit hundert Jahren locken diese Wörter die Forscher: Da sind sie, die Beschriftungen, da sind die Namen. Gelesen hat sie niemand, uns eingeschlossen. Aber in zwei Jahren haben wir über sie mehr erfahren als über jeden anderen Teil des Buches, und dieses Wissen ist strukturell, nicht wörtlich.
Es sind dreißig, und sie sind einmalig
Fangen wir mit der Zahl an. Auf den Blättern f73r und f73v stehen genau je dreißig Beschriftungen; im Mittel über die Ringe rund dreißig einmalige je Zeichen. Dreißig Grade, dreißig Tage - eine Übereinstimmung, an der man nicht vorbeigehen kann. Dabei wiederholen sich die Beschriftungen fast nie, weder innerhalb eines Rings noch zwischen den Ringen: Der Anteil verschiedener Formen liegt bei ihnen bei 0.77-0.80 gegen 0.20 im gewöhnlichen Text der Handschrift, und zwei Ringe haben praktisch keine gemeinsamen Etiketten (Ähnlichkeitsmaß 0.005). Jedes Zeichen hat seine eigene Liste.
Die erste Hypothese drängt sich von selbst auf: Es sind Nummern. Wir haben sie auf vier Wegen geprüft, und viermal fiel sie durch. Der anschaulichste: Benachbarte Zahlen werden ähnlich geschrieben - 21, 22, 23 teilen die erste Ziffer. Wären die Etiketten Zahlen, müssten benachbarte Etiketten auf einem Ring einander ähneln. Das Nachbarschaftsmaß liegt bei der Handschrift bei +0.8, bei echten Zahlwörtern bei etwa +7. Die Etiketten zählen nicht.
Eine eigene Grammatik
Ein Etikett ist nicht einfach ein kurzes Wort aus dem Text. Es hat eine eigene Grammatik, und wir haben sie mit sechs Markern gemessen. Die Nullkontrolle ist hier wichtig: Etiketten unmittelbar mit dem Text zu vergleichen wäre unfair, Etiketten sind kürzer. Deshalb wurde die Marke „Etikett“ oder „Text“ innerhalb der Schichten „Abschnitt × Wortlänge“ gemischt - 90 Schichten, 10 000 Permutationen. Das ist übrig geblieben.
| Marker | bei Etiketten | im Text | wievielfach |
|---|---|---|---|
anlautendes o- | 53.8 % | 20.6 % | 2.6 |
anlautendes qo- | 0.9 % | 15.2 % | 17 (seltener) |
verdoppelte Silbe (olol, arar) | 3.05 % | 0.57 % | 5.3 |
auslautendes -n | 7.5 % | 16.5 % | 2.2 (seltener) |
| verdoppelter Buchstabe | 16.1 % | 24.9 % | seltener |
seltene Zeichen x, v, g, b | 1.92 % | 0.44 % | 4.4 |
Alle sechs sind auf dem Niveau 0.001 signifikant. Ein merkwürdiger Kontrast: Die verdoppelte Silbe mögen die Etiketten, den verdoppelten Buchstaben meiden sie. Das häufigste Präfix des Textes, qo-, ist in den Etiketten fast verboten - ein Registerwechsel, als schriebe man in einer Namensliste keine Artikel.
Es sind Siglen
Wie lang darf ein Name sein, damit er in ein Etikett passt? Nach den Chiffretabellen der Naibbe-Klasse fallen die Wörter des Textes auf einbuchstabige Verschlüsselungen (erwartete Länge 4.43 Zeichen bei beobachteten 4.45), die Etiketten dagegen auf zweibuchstabige (5.15 bei 5.37). Dreibuchstabige verlangt keines der 344 Tierkreis-Etiketten. Ein vollständiger Name passt nicht hinein. Hinein passt eine Sigle - die Abkürzung auf zwei Buchstaben, die übliche Praxis mittelalterlicher Listen.
Dann kam die Prüfung, die uns mehr als alle anderen überzeugt hat. Ist ein Etikett zwei unabhängig verschlüsselte Buchstaben, dann müssen Etikettenpaare innerhalb eines Rings manchmal genau einen der beiden Teile teilen (einen gemeinsamen ersten oder einen gemeinsamen zweiten Buchstaben), und zwar öfter als zufällig. So ist es: p unter 0.001 in beide Richtungen. Die Etiketten des pharmazeutischen Abschnitts dagegen - einmalige Pflanzennamen - zeigen keine solche Signatur. Es liegt also nicht an einer allgemeinen Formdrift, sondern am Bau gerade der Tierkreis-Etiketten.
Später haben wir präzisiert: Ein Etikett braucht keinen eigenen Abschnitt des Schlüssels. Etikettenformen, die nicht im Lexikon der Tabellen stehen, zerlegen sich in 78.6 % der Fälle als „ein Schlüsselwort plus eine weitere Zelle zusammengeschrieben“, gegen 58.5 % bei Pseudowörtern - genau wie ungewöhnliche Formen im Text. Ein Etikett ist zwei bis drei Codeeinheiten aus demselben Schlüssel.
Ein unabhängiger Zeuge
In einer Untersuchung, in der alles an der Zerlegung einer einzigen Transliterationsdatei hängt, braucht es eine äußere Kontrolle. Sie fand sich: der Datensatz von Keito Yoshida, aus derselben Datei mit anderem Code gewonnen und offen veröffentlicht. Wir haben ihn mit unserer Zerlegung abgeglichen: 883 Loci von 883, 1021 Token von 1021, 747 Typen von 747, null Abweichungen, alle zehn Klassen von Loci stimmen überein. Das Inventar der Etiketten ist unabhängig bezeugt.
Wo der Inhalt sitzt
Es gibt noch eine Dimension, die die Etiketten heraushebt. Vergleicht man den Absatztext der Handschrift mit unserem Generator, sind beide fast ununterscheidbar: Ähnlichkeit zwischen den Zeilen 0.068 gegen 0.090, Wortschatzanteil 0.198 gegen 0.107, Entropie 2.18 gegen 2.10. Die Etiketten stehen auf allen Achsen vom Generator ab: 0.006, 0.728, 2.53. Die Prosa der Handschrift ähnelt statistisch einer seriellen Prozedur; was im Buch unterscheidend ist, sitzt in den Etiketten.
Der Stamm ist dem Blatt gemeinsam
Der jüngste Befund stammt aus dem Oktober 2026. Wir haben gefragt: Ist der Stamm eines Etiketts (seine ersten Zeichen) eine Eigenschaft des Rings oder eine Eigenschaft des Blatts? Sind die Etiketten Namenslisten, muss der Stamm am Blatt sitzen; ist es ein Dialekt des Schreibers, muss er auch im Text desselben Blatts sitzen. Die Stämme der Etiketten sind je Blatt stärker konzentriert als die Textwörter derselben Blätter: z +8.05 gegen das 97.5. Perzentil des Textes von 3.52; zwei Blätter desselben Monats ergeben verschiedene Stämme (p 0.005). Die Etiketten sind wie ein Nomenklator gebaut - eine Liste mit gemeinsamem Anfang je Seite. Teststärke 1.0, p 0.0004.
Der nächste Schritt - der Schwanz des Etiketts als Unterscheider innerhalb des Blatts - stieß an den Umfang: 244 Etiketten länger als fünf Zeichen auf zwölf Blättern geben keine Teststärke (0.29 bei einer Schwelle von 0.8). Diese Frage lässt sich an den vorhandenen Etiketten nicht entscheiden.
Warum die Etiketten nicht lesbar sind
Die Etiketten sind der beste Anker der Handschrift, und gerade deshalb haben wir auf sie am meisten verwendet: achtzehn Klassen äußerer Listen mit dreißig je Zeichen, vom Cisiojanus bis zu den Gradbildern des Astrolabium von 1488 und den Heiligenkalendern. Eine Liste - der Kalender von Lleida - nahm drei Hürden und erwies sich als Artefakt. Alle übrigen - null.
Und dann greift die Arithmetik: Selbst wenn wir die richtige Liste fänden, sind dreißig zweibuchstabige Siglen sechzig Buchstaben. Um einen Schlüssel aus sechs Tabellen wiederherzustellen, braucht es zwei Größenordnungen mehr. Mehr dazu im Artikel Ankerschwelle.
Zum Verständnis: Alles oben betrifft die Form der Etiketten und ihre Verteilung, nicht Lesungen. Ein Erfolg wäre eine äußere Handschrift derselben Tradition mit einer Namensliste von dreißig je Zeichen und einem gemeinsamen Stamm je Seite.
Häufige Fragen
Warum können die Etiketten nicht die Zahlen von 1 bis 30 sein?
Kodierten die Etiketten Gradnummern, dann müssten benachbarte Etiketten einander ähneln, wie die Schreibungen benachbarter Zahlen einander ähneln. Sie tun es nicht - die Nachbarschaftsstatistik liegt bei der Handschrift bei 0.8 gegen 7 bei echten Zahlwörtern. Die Ringe teilen fast keine Etiketten miteinander. Auf vier unabhängigen Wegen geprüft.
Was ist eine Sigle?
Die Abkürzung eines Namens auf ein bis zwei Buchstaben, wie sie in mittelalterlichen Listen und Kalendern üblich war. Die Kapazität eines Etiketts beträgt nach den Chiffretabellen genau zwei Buchstaben - ein vollständiger Name passt physisch nicht hinein.
Woher die Sicherheit, dass das Inventar der Etiketten richtig zerlegt ist?
Der unabhängige Datensatz von Keito Yoshida, aus derselben Transliterationsdatei mit anderem Code gewonnen, stimmte mit unserer Zerlegung bis zum letzten Zeichen überein - 883 Loci von 883, 1021 Token von 1021, null Abweichungen.
Lässt sich über die Etiketten ein Schlüssel finden?
Das war die große Hoffnung des Projekts - eine äußere Liste von Namen, dreißig je Zeichen. Achtzehn Klassen solcher Listen sind geprüft und verworfen, darunter die Gradbilder des Astrolabium von 1488 und Heiligenkalender. Für sich allein sind die Etiketten zu kurz, um als Anker zu dienen.